DeepSeek nói mở hết DeepInfer, README ghi còn thiếu 3 phần
DeepSeek DeepInfer là bộ máy chạy V4.1 Flash, nay mở mã Apache 2.0. Phần lưu cache làm giá rẻ vẫn giữ lại, vậy ai nên tải về?

Mục lục
Ngày 20/10/2026, DeepSeek vừa mở mã nguồn chính bộ máy họ dùng để chạy AI cho người dùng.
Họ đưa lên GitHub mã nguồn của DeepInfer — hệ thống dùng phục vụ model DeepSeek V4.1 Flash.
Hãng nói mở hoàn toàn. Nhưng khi đọc kho mã nguồn của DeepSeek trên GitHub, Tuấn thấy tài liệu ghi rõ họ còn thiếu 3 phần quan trọng!
TÓM TẮT NHANH
- Chiều 20/10/2026, DeepSeek phát hành mã nguồn DeepInfer chạy model V4.1 Flash theo giấy phép Apache 2.0.
- Hãng nói mở hết, nhưng tài liệu ghi thiếu 3 phần: lưu KV cache, tách khâu và cân tải.
- Theo DeepSeek, một cụm máy phục vụ 155 nghìn tỷ token/ngày, 96% input trúng cache; giá input trúng cache chỉ bằng 1/50 giá thường.
- Muốn dựng hiệu quả cần khoảng 128 GPU; người dùng app hay API ở Việt Nam không phải đổi gì.
1. DeepSeek DeepInfer có gì mới
Ngày 20/10/2026, DeepSeek chính thức phát hành mã DeepInfer theo giấy phép Apache 2.0 cho phép dùng thương mại.
Đây là bộ máy suy luận nội bộ họ dùng để chạy model DeepSeek V4.1 Flash. Họ mở kèm công cụ deepseek-recipe mang giấy phép MIT.
1.1 DeepSeek DeepInfer là gì
Nhiều người sẽ hỏi: DeepSeek DeepInfer là cái gì?
Nếu model AI là bộ não, thì DeepInfer là căn bếp lớn. Căn bếp này chia việc cho hàng chục GPU để phục vụ hàng triệu người.
Tài liệu ghi bộ máy này ban đầu xây trên vLLM. Nó có kernel tối ưu, giải mã suy đoán DSpark và ép kết quả theo chuẩn JSON hay regex.
Đọc danh sách tính năng mà Tuấn thấy họ tối ưu rất sâu cho kiến trúc MoE rồi đó!
1.2 DeepInfer còn thiếu phần cache và cân tải
Tuyên bố trên X nói mở hoàn toàn, nhưng tài liệu lại là chuyện khác.
Trong README, DeepSeek thừa nhận bản này chỉ chạy offline và thiếu 3 phần. Đó là hệ thống lưu KV cache, khâu tách prefill và decode, cùng bộ phận cân tải.
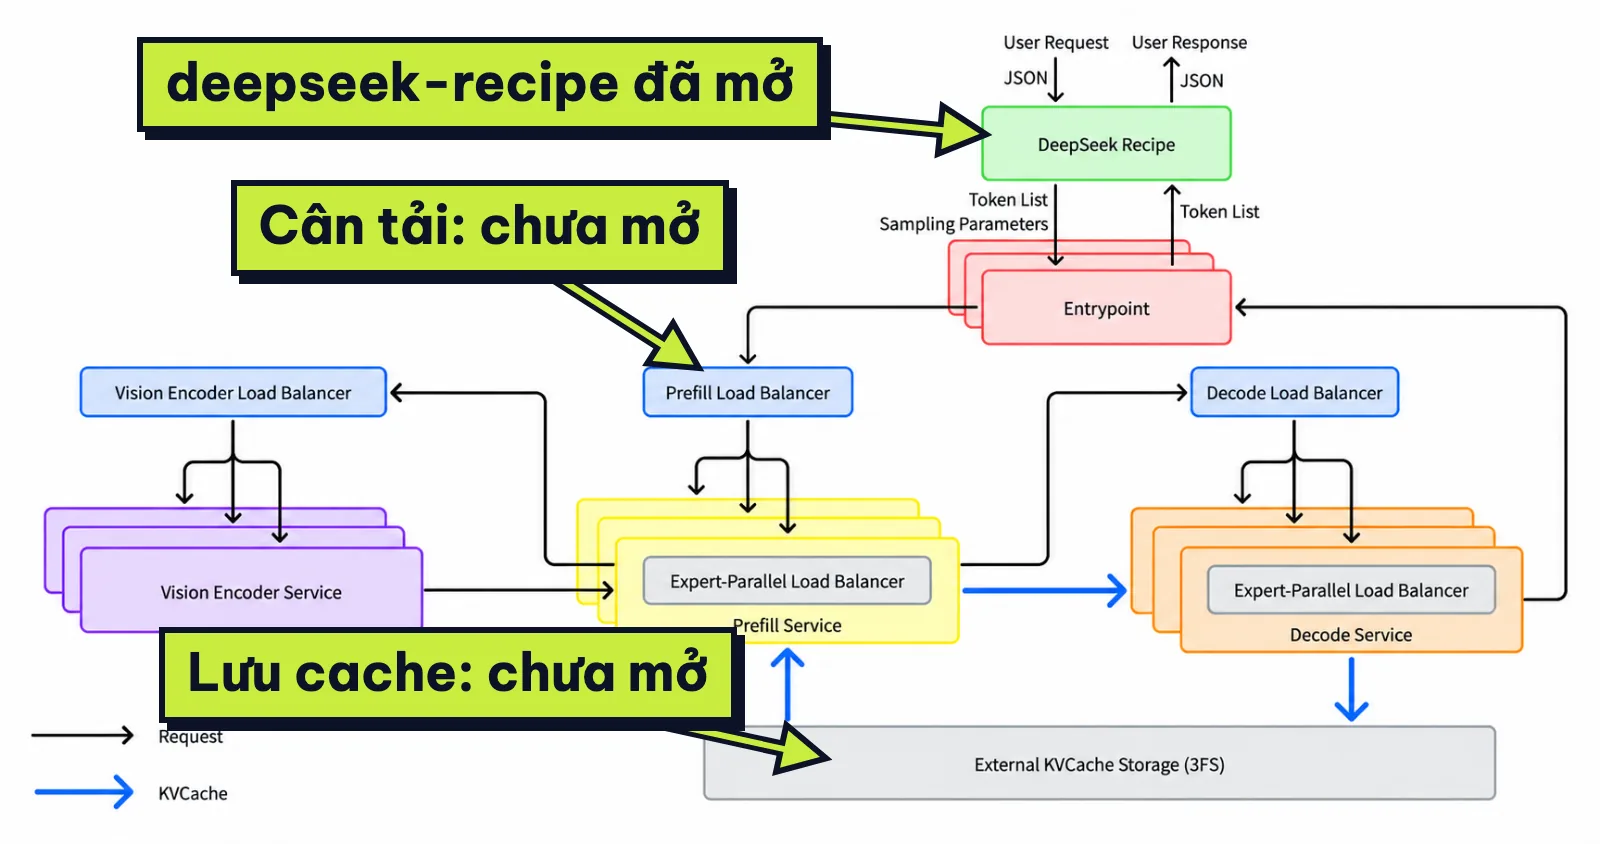
Hãng giải thích quản lý cache và cân tải gắn quá chặt vào hạ tầng nội bộ nên chưa mở hết.
Ai muốn tự dựng chỉ có thể đọc bài trên Zhihu để tham khảo thiết kế rồi tự viết lấy thôi nha!
1.3 Vì sao DeepSeek bán rẻ: cache giữ tới 7 ngày
Điều làm Tuấn chú ý nhất đợt này là những con số DeepSeek tiết lộ về hạ tầng của họ.
Theo DeepSeek, một cụm máy của họ phục vụ tới 155 nghìn tỷ token mỗi ngày.
Đáng nể hơn, tỷ lệ câu hỏi đầu vào trúng cache lưu sẵn đạt trung bình tới 96%!
Bí quyết nằm ở chỗ hãng lưu KV cache trên cụm ổ SSD riêng dùng hệ tệp 3FS, dung lượng khoảng 100 PiB.
Tác vụ agent được giữ cache 3 ngày, còn chatbot thông thường được giữ tới 7 ngày.
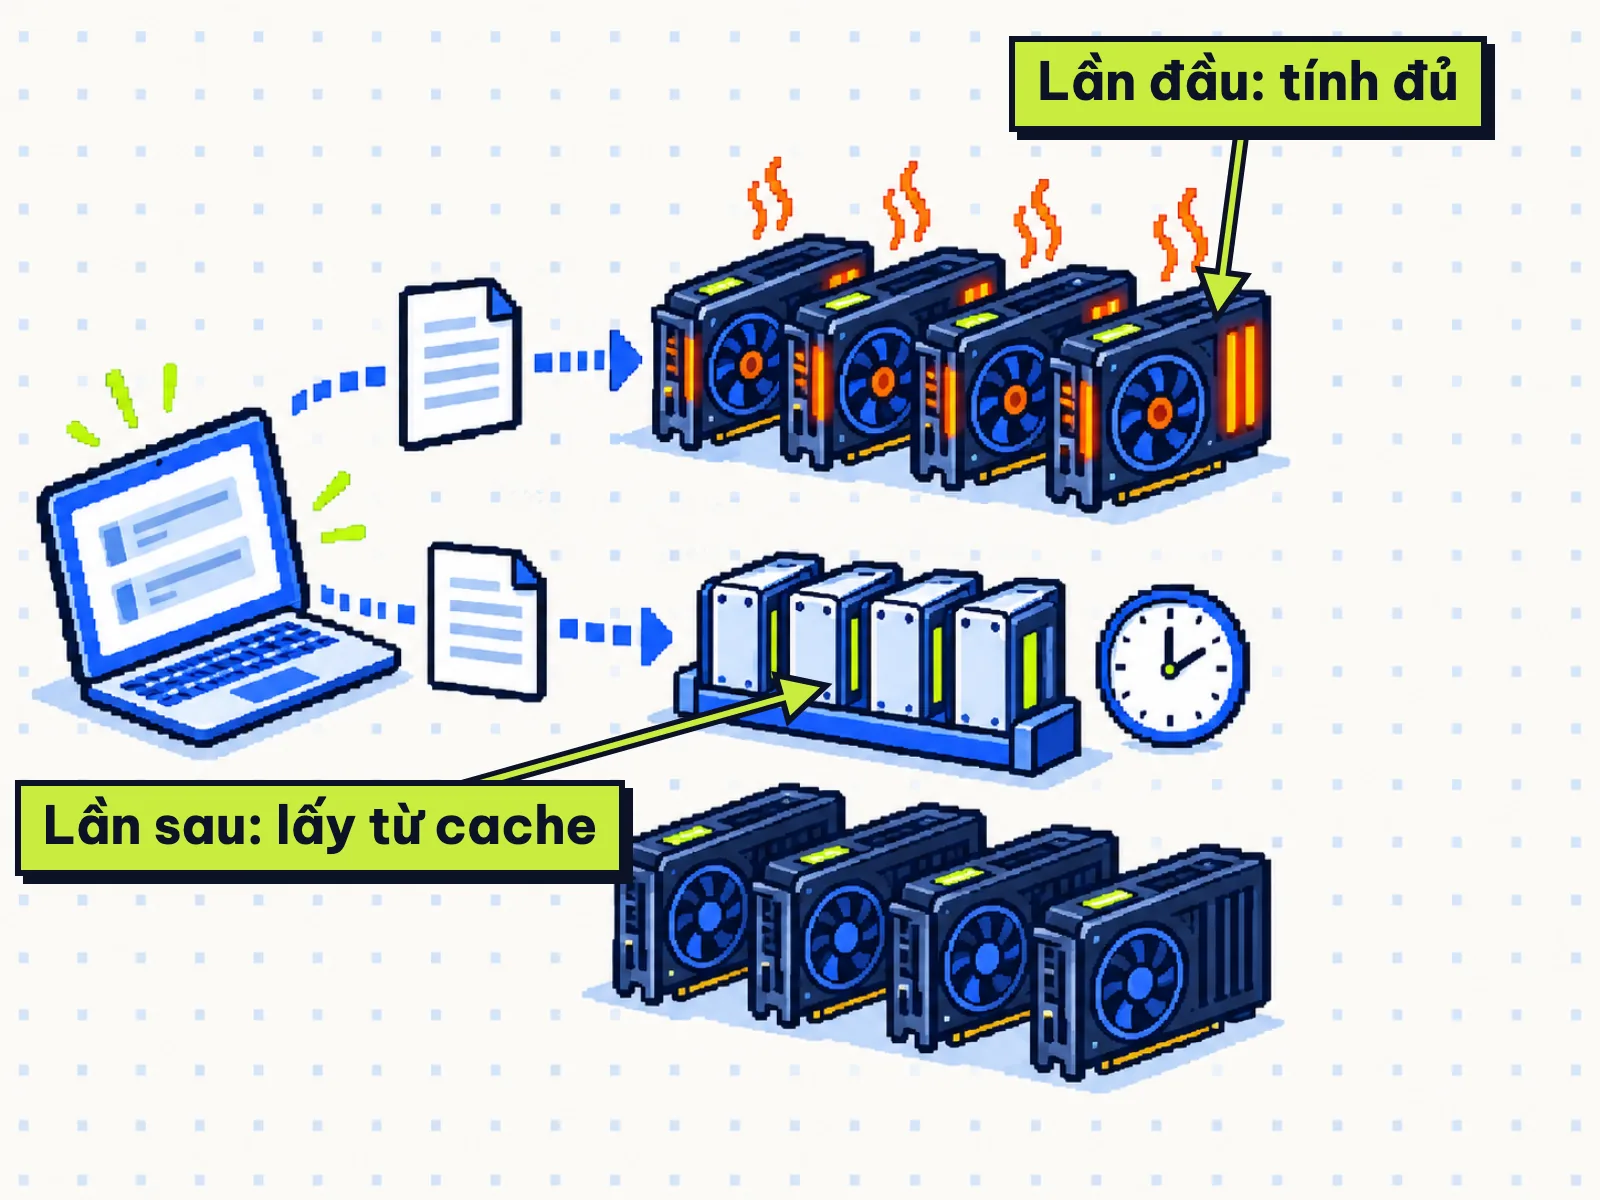
Mỗi khi bạn gửi yêu cầu, hệ thống đối chiếu phần đầu văn bản với dữ liệu lưu trên SSD.
Nếu trùng, hệ thống lấy kết quả cũ ra dùng luôn thay vì tính lại từ đầu.
Theo DeepSeek, dùng lại cache như vậy giúp họ giảm chi phí tính toán đáng kể.
1.4 So sánh giá API và số đo hệ thống của DeepSeek
Nhìn sang bảng giá API mới thấy trúng cache đáng tiền cỡ nào.
Giá tính bằng USD cho 1 triệu token của model deepseek-flash:
| Loại token | Thấp điểm | Cao điểm |
|---|---|---|
| Input trúng cache | 0,003 | 0,006 |
| Input thường | 0,15 | 0,30 |
| Output | 0,6 | 1,2 |
Giá tính cho model deepseek-flash (V4.1 Flash 1017), theo trang giá DeepSeek đọc ngày 20/10/2026. Khung giờ cao điểm là 8–11 giờ và 13–17 giờ thứ Hai đến thứ Sáu theo giờ Việt Nam.
Nhìn vào bảng là thấy ngay: phần đầu vào trúng cache rẻ chỉ bằng 1/50 giá thường!
Ở giờ thấp điểm, 1 triệu token trúng cache tốn 0,003 USD, tức khoảng 78 đồng tiền Việt.
Còn dưới đây là số liệu trên hệ thống thật do DeepSeek tự công bố:
| Chỉ số | DeepSeek ghi |
|---|---|
| Token mỗi ngày, một cụm | 155 nghìn tỷ |
| Input trúng cache | 96% |
| Input bình quân | 77K token |
| Chờ chữ đầu (bình quân) | 400 ms |
| Tốc độ ra chữ | 230 token/giây |
| Giữ cache sau khi ngừng | 72 giờ |
Số do DeepSeek tự công bố trong tài liệu ngày 20/10/2026, chưa có bên nào đo lại.
Họ nêu doanh thu thấp điểm là 38 USD mỗi thẻ mỗi giờ, nhưng không nói rõ dòng card nào.
1.5 Cần máy gì để tự chạy DeepInfer
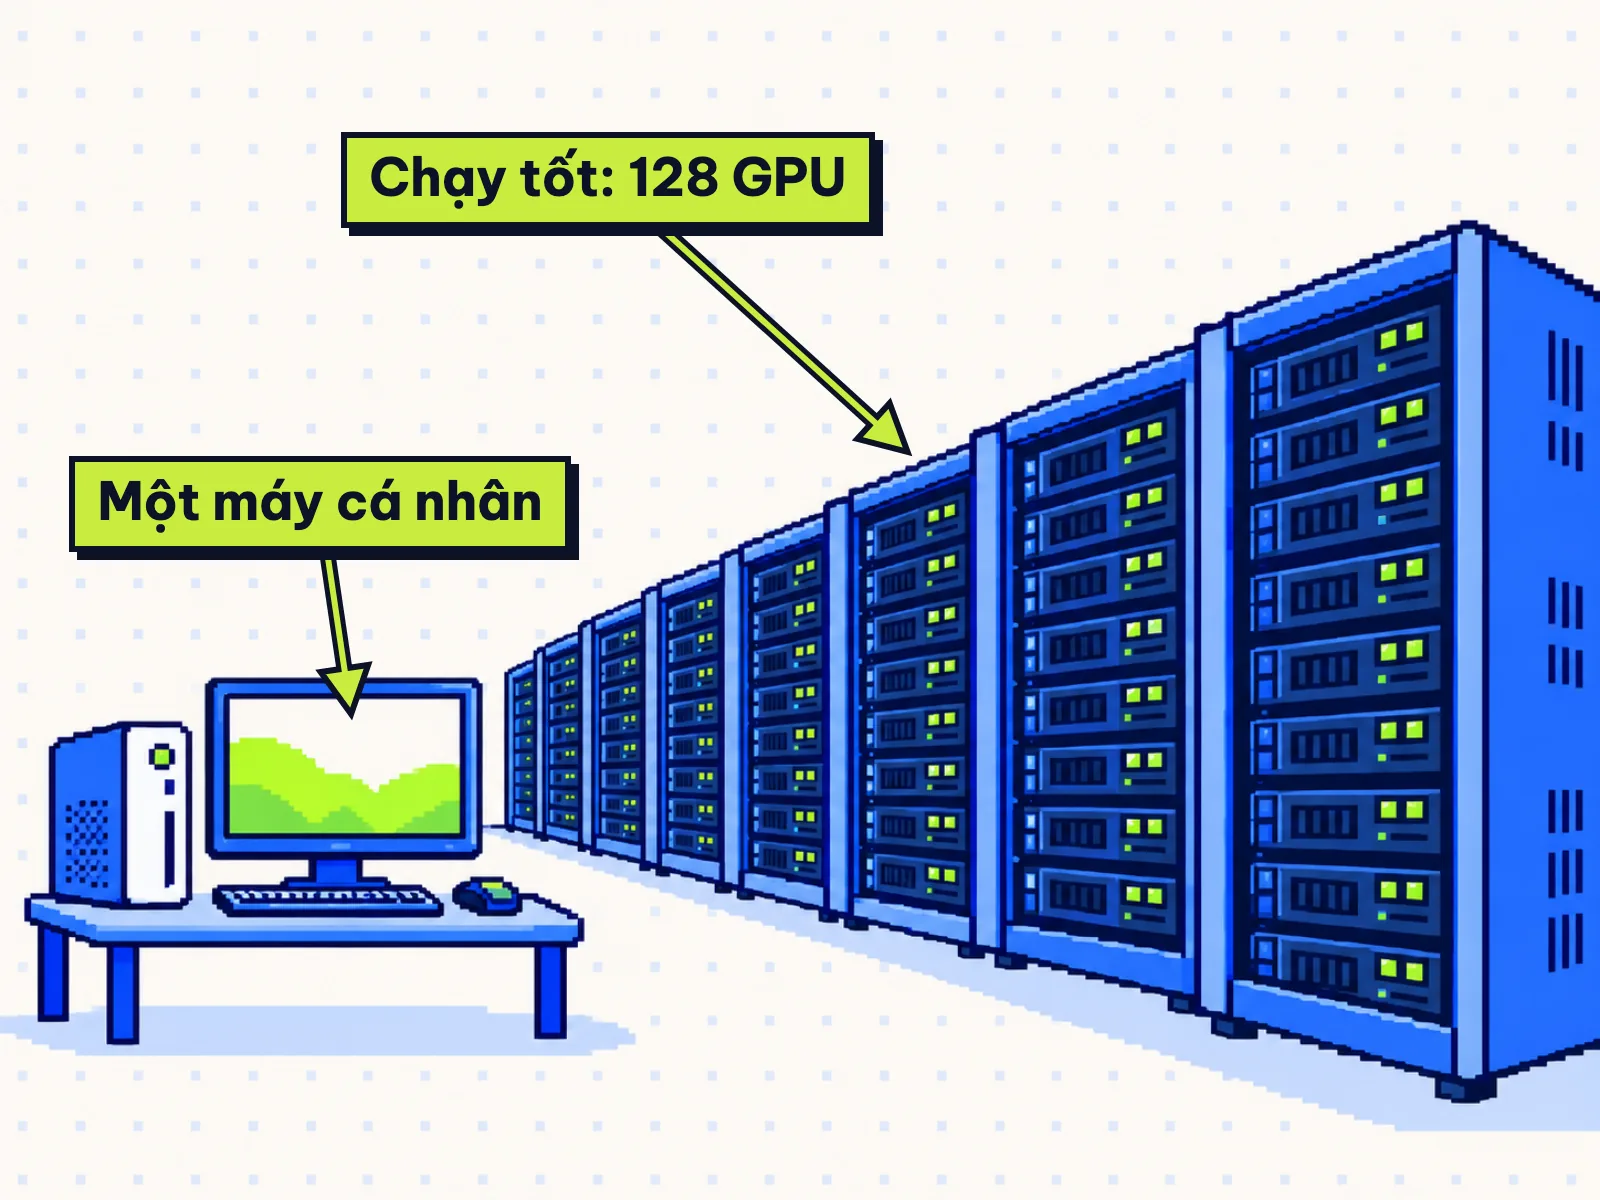
Nghe hấp dẫn như vậy, nhưng liệu chúng ta có thể tải về chạy trên máy tính cá nhân không?
Câu trả lời ngắn gọn là không đâu nhé!
DeepInfer hiện chỉ hỗ trợ phần cứng GPU NVIDIA kiến trúc SM100 và chip Huawei Ascend 950.
Nó cũng đòi hỏi môi trường Linux, Python 3.12 cùng CUDA 13 hoặc CANN 9.2.
DeepSeek cho biết chỉ cần 1 khâu prefill và 1 khâu decode là đã triển khai được.
Để vận hành hiệu quả, hãng khuyên cấu hình nhỏ nhất là 64 GPU prefill và 64 GPU decode (tổng 128 GPU).
Họ không công bố số so với vLLM hay SGLang, chỉ tự đo trên máy nội bộ.
2. Chúng mình ở Việt Nam cần lưu ý gì
Tài liệu công bố không nhắc tới Việt Nam.
Người dùng app hay web ở Việt Nam không bị ảnh hưởng gì.
Khung cao điểm 8–11 giờ và 13–17 giờ ngày thường sẽ bị nhân đôi giá API.
Theo Vietcombank ngày 20/10/2026 (26.060 đ/USD), 1 triệu token input trúng cache chỉ tốn 78 đồng.
Trượt cache giờ cao điểm, 1 triệu token input vọt lên khoảng 7.800 đồng.
Với doanh nghiệp định tự dựng, việc cần tính trước là có đủ 128 GPU SM100 hoặc Ascend 950 hay không.
3. Góc nhìn của Tuấn
Thứ đáng đọc nhất đợt này là tài liệu kiến trúc, không phải bản mã nguồn.
Tuấn thấy DeepSeek rất sòng phẳng khi giải thích bằng số vì sao giá API của họ rẻ.
Hình dung bạn làm chatbot bán hàng: mỗi câu khách hỏi đều gửi kèm một bản hướng dẫn dài. Để bản hướng dẫn đó đứng đầu và giữ nguyên từng chữ, phần này chỉ bị tính bằng 1/50 giá input thường.
Nhưng nói “mở hoàn toàn” chỉ là quảng bá. Phần cốt lõi giúp giá rẻ vẫn nằm ở hạ tầng riêng của DeepSeek.
Trên Hacker News, vài người chỉ thẳng: thiếu KV cache thì khó tự dựng thành dịch vụ. Có người lại đoán giá API của các model không phải hàng đầu sẽ giảm thêm.
4. Bạn nên làm gì
- Dùng app, web: Cứ dùng bình thường, không cần cài thêm gì.
- Gọi API lặp lại: Đặt tài liệu cố định ở đầu yêu cầu và giữ nguyên từng chữ để trúng cache. Việc không gấp thì chạy ngoài giờ cao điểm để được nửa giá, xem ở trang giá API của DeepSeek.
- Tự chạy model riêng: DeepInfer cần cỡ 128 GPU SM100 hoặc Ascend 950 để chạy hiệu quả. Ít máy hơn thì cứ dùng vLLM hay SGLang quen thuộc.
- Cho thuê API, cloud: Dùng repo deepseek-recipe để chuẩn hoá API. Nhớ kiểm tra giấy phép Apache 2.0 và MIT trước khi kinh doanh.
Bạn gọi API DeepSeek cho việc gì và đã để ý tiền cache chưa? Để lại bình luận cho Tuấn biết nhé.
5. Nguồn
- DeepSeek trên GitHub — repo DeepInfer (README, giấy phép, tài liệu hỏi đáp triển khai), 20/10/2026.
- DeepSeek trên X — thông báo mở mã DeepInfer và deepseek-recipe (20/10/2026).
- DeepSeek trên Zhihu — bài kể cách dựng hệ thống suy luận V4.1 Flash và số vận hành thật.
- DeepSeek — trang giá API (đọc 20/10/2026).
- Vietcombank — tỷ giá USD bán ra 26.060 đ (23:14 20/10/2026), dùng để quy đổi ước.
- Diễn đàn Hacker News — ý kiến lập trình viên về DeepInfer.
Tin mới về DeepSeek
Để lại bình luận