Chọn Claude Opus 5.5 hay Gemini 4 Argon theo từng việc và tiền thật?
Khi xét Gemini Argon vs Claude, code ngang nhau nhưng dựng app một lượt chọn Opus, còn tự động hoá văn phòng lấy Argon.
Mục lục
- 1. Gemini 4 Argon vs Claude Opus 5.5: so nhanh trong một bảng
- 2. Code và agent: hai model sát nút
- 3. Nhờ dựng trọn app, web, game: Opus 5.5 ra bản đẹp hơn
- 4. Việc văn phòng, giấy tờ chuyên ngành, báo cáo
- 5. Hỏi kiến thức: ít đoán bừa chưa chắc đã trả lời đúng nhiều
- 6. Tốc độ và game chiến lược
- 7. Tiền mỗi việc trước và sau 01/12
- 8. Dùng qua gói tháng: ở đâu có cả hai, ai hết lượt trước
- 9. Có Gemini 4 Hydrogen rồi, việc thường còn cần Argon hay Opus 5.5 không
- 10. Đặt GPT-6.1 Sol và GPT-6 Astra vào thì sao
- 11. Chọn Gemini Argon hay Claude Opus 5.5 cho việc của bạn
Khi đặt lên bàn cân Gemini 4 Argon vs Claude Opus 5.5, bạn hãy giao việc văn phòng với giấy tờ chuyên ngành cho Argon. Còn lúc cần dựng app có giao diện hay soạn báo cáo đẹp thì chọn Opus 5.5.
Riêng khoản lập trình và sửa lỗi, hai bên sát nút nhau lắm.
Google mở Gemini 4 Argon từ ngày 13/10/2026 để đấu thẳng với Claude Opus 5.5 ra ngày 22/09. Hiện Tuấn đang dùng gói Google AI Ultra nên ít phải cân đo từng lượt.
Nhưng người dùng gói Google AI Pro hoặc gói Claude rất dễ hao tiền nếu chọn nhầm bên. Xem xong bài này, bạn sẽ biết giao việc nào cho ai và tốn bao nhiêu tiền thật trước lẫn sau ngày 01/12.
TÓM TẮT NHANH
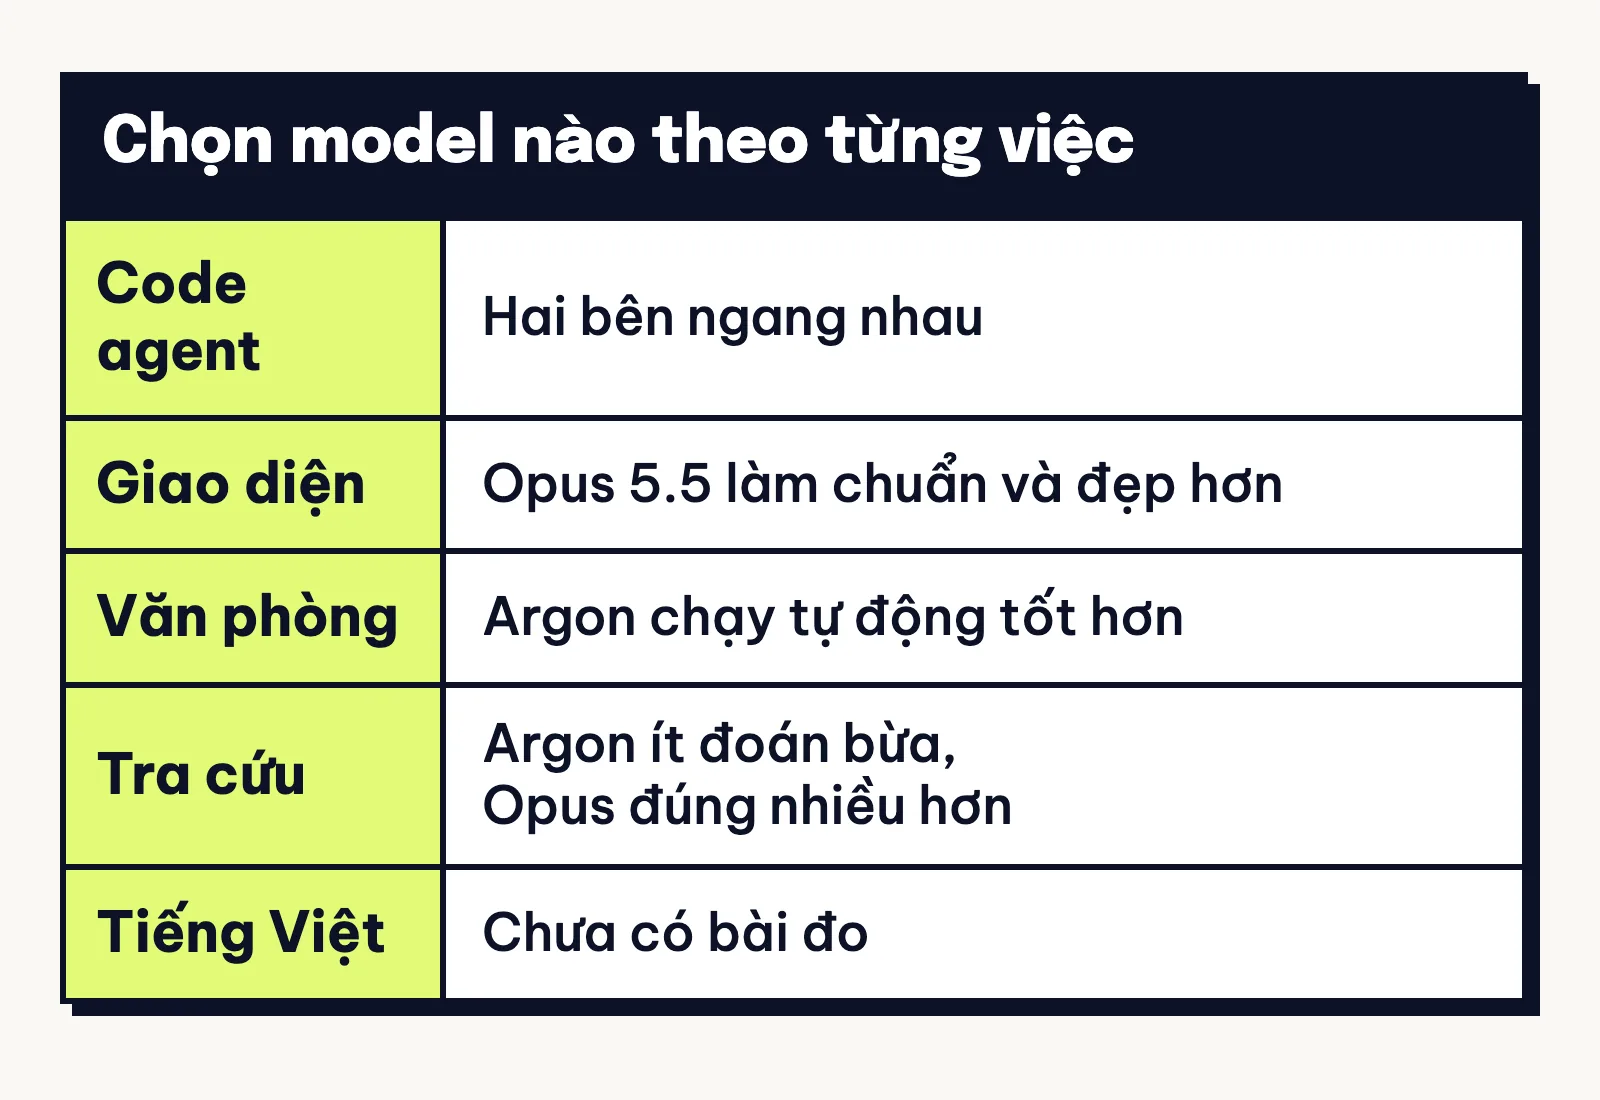
- Viết code và sửa bug ngang nhau, các bài đo chênh chừng 1 việc hay 1 điểm.
- Dựng app hay web có giao diện trong một lần thì Opus 5.5 đẹp và chuẩn hơn.
- Nối nhiều app văn phòng hoặc làm giấy tờ luật, y, kế toán thì Argon nhỉnh hơn.
- Dựng app một lượt thì Argon rẻ hơn. Trên bài đo độc lập cùng mức suy luận high, Opus 5.5 lại rẻ hơn. Giá token Argon gấp đôi từ 01/12.
- Gói Google AI Pro trả tiền có hai model trong Antigravity, công cụ code của Google.
1. Gemini 4 Argon vs Claude Opus 5.5: so nhanh trong một bảng
Trước khi đi vào từng mảng, bạn lướt qua bảng thông số gốc của hai model nhé.
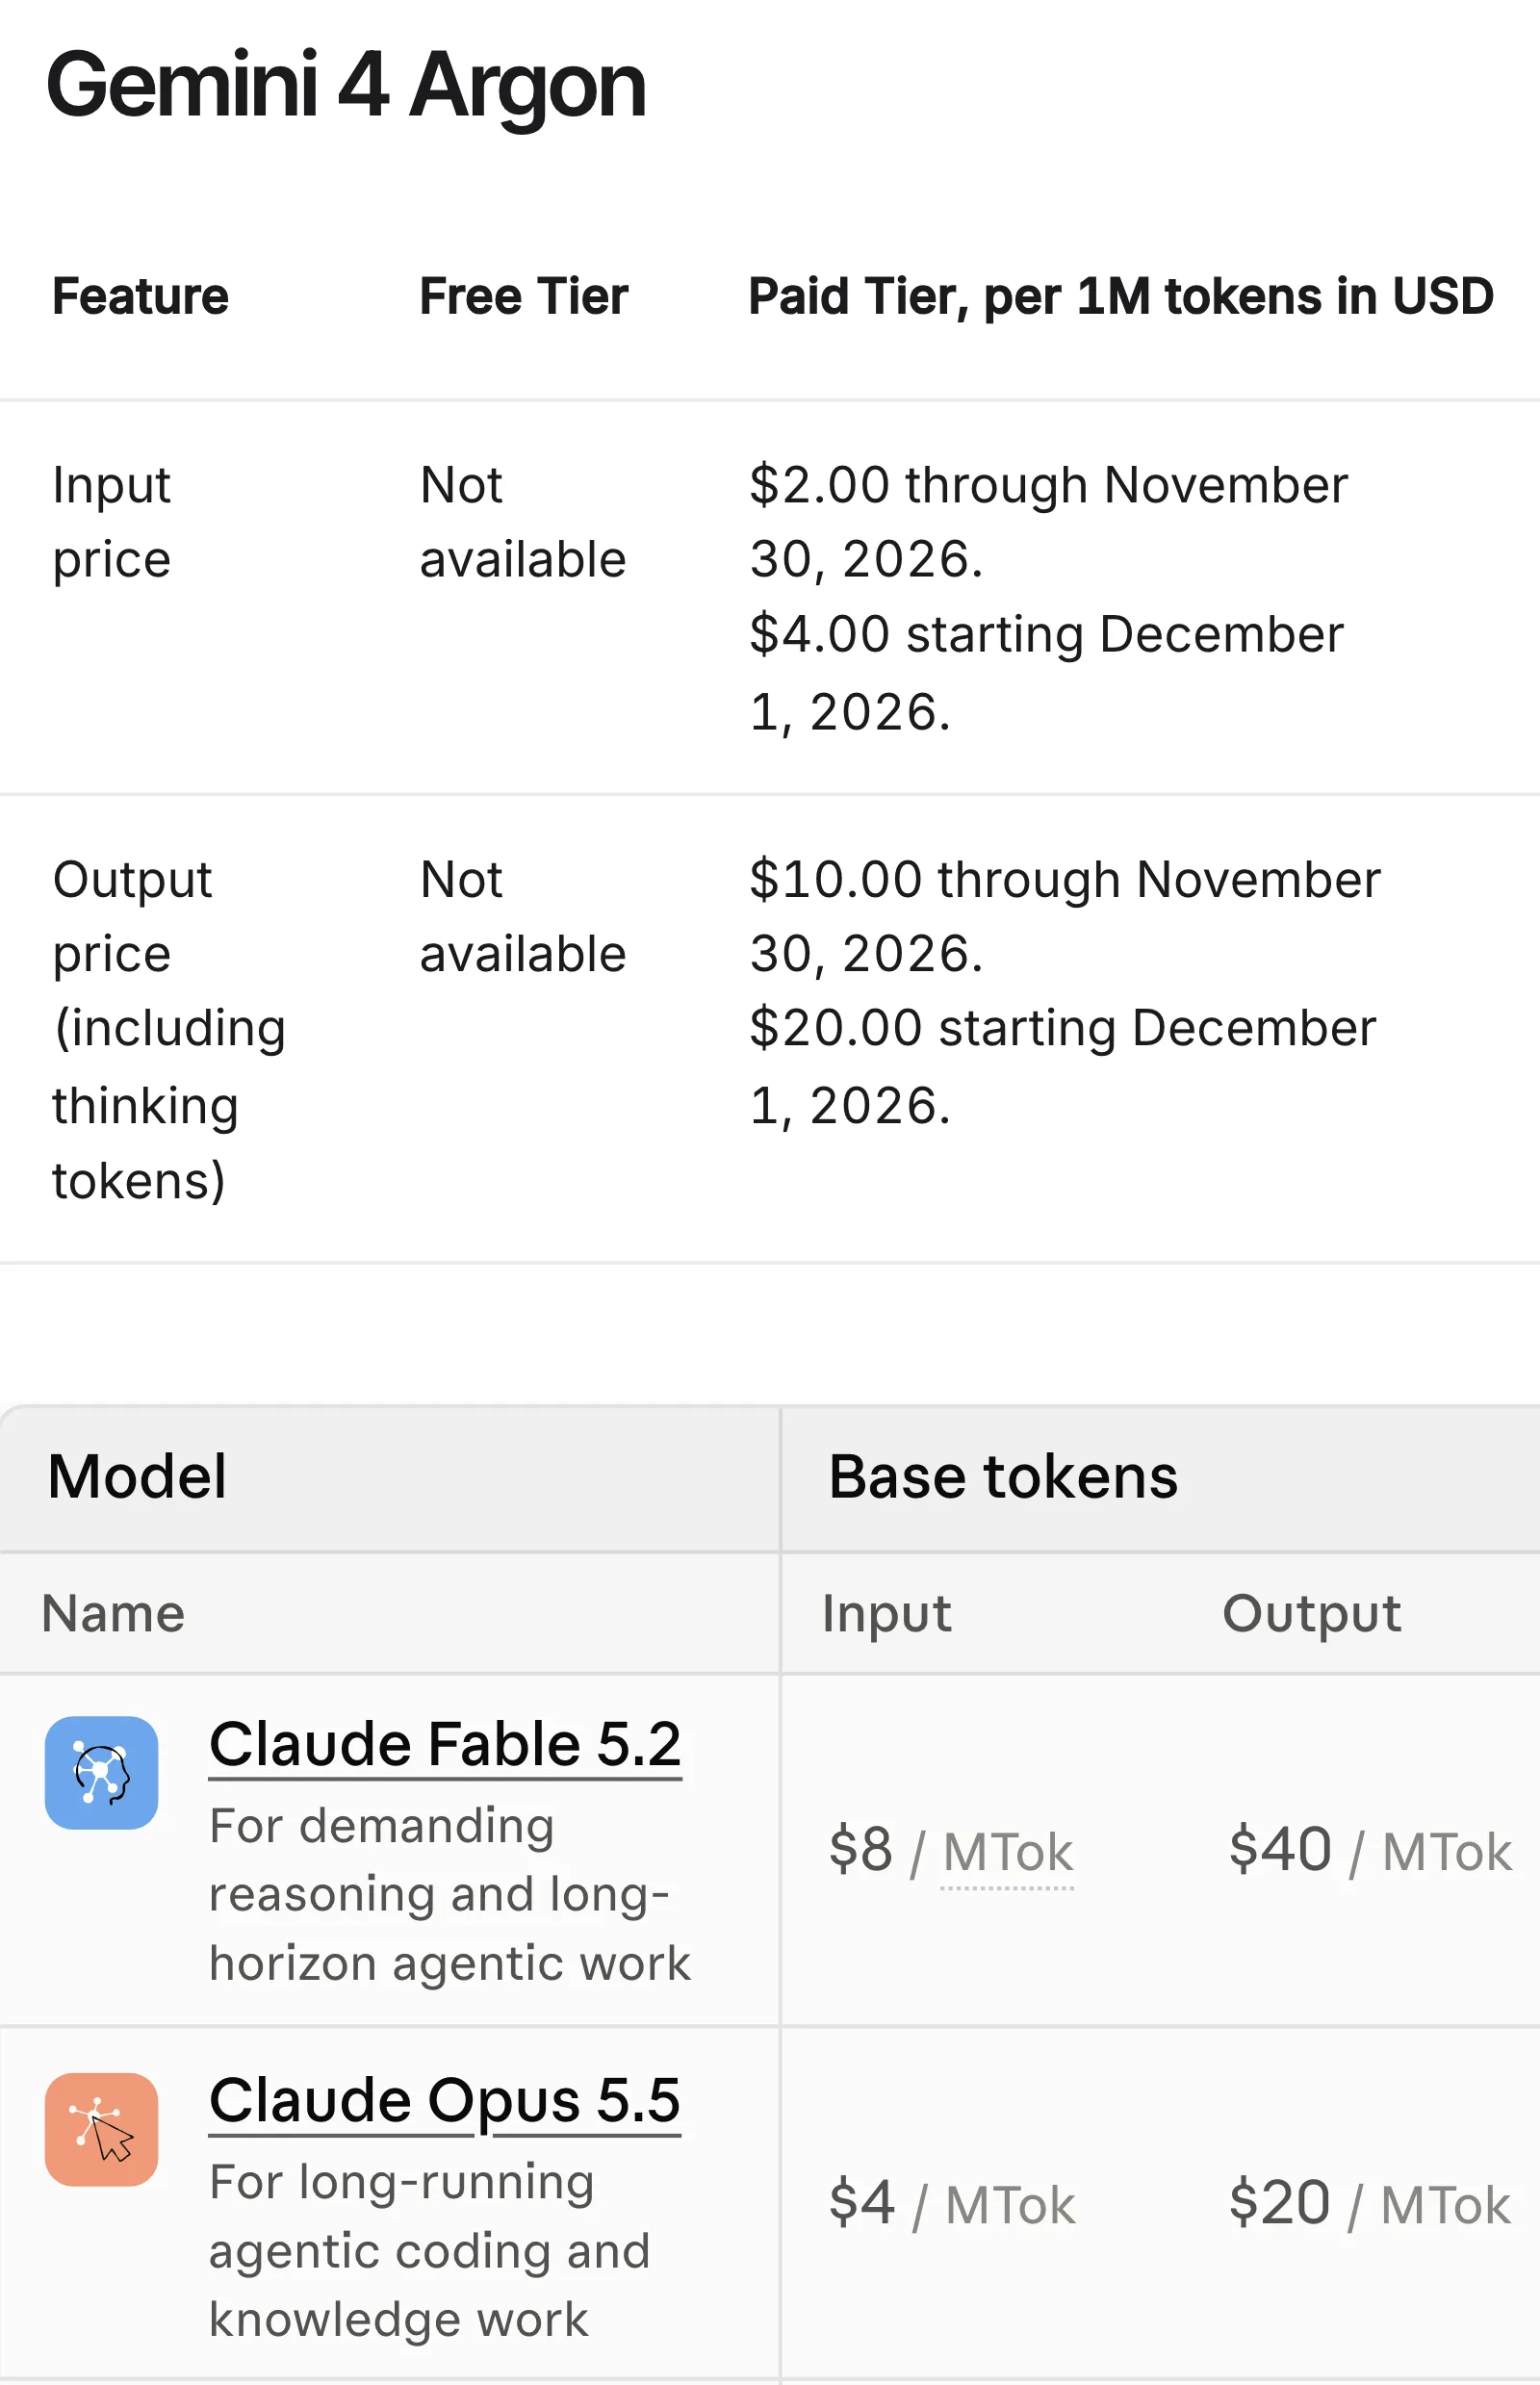
| Tiêu chí | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|
| Hãng và ngày ra | Google, ra ngày 13/10/2026 | Anthropic, ra ngày 22/09/2026 |
| Giá token tới 30/11 | $2 vào và $10 ra mỗi triệu | $4 vào và $20 ra mỗi triệu |
| Giá token từ 01/12 | $4 vào và $20 ra mỗi triệu | $4 vào và $20 ra mỗi triệu |
| Ngữ cảnh và đầu vào | 1.048.576 token, chữ, ảnh, video, âm thanh, PDF | 1 triệu token, chữ, ảnh, PDF (không video, âm thanh) |
| Mức suy luận | low, medium mặc định, cao nhất high | low, medium mặc định, tới xhigh, max |
| Gói tháng có model | Google AI Pro trở lên | Claude Pro trở lên, Antigravity từ Google AI Pro |
| Điểm Artificial Analysis | 50 điểm ở mức high | 52 điểm ở high, 59 điểm ở max |
Nhìn bảng giá gốc thì Argon chỉ rẻ hơn tới hết 30/11, sau đó hai bên bằng giá.
Đọc bảng sao cho đúng: giá token, mức suy luận và điểm
Trong bảng có giá token, tức tiền tính cho mỗi 1 triệu token vào và ra. Hãng niêm yết rõ trên trang giá Gemini API của Google và trang giá Claude API của Anthropic.
Trong bảng có mục mức suy luận, là độ kỹ mà model nghĩ trước khi trả lời. Càng nghĩ lâu thì câu trả lời càng tốn nhiều token hơn.
Mặc định cả hai đều ở medium, Argon lên tối đa high còn Opus 5.5 tới xhigh và max. App Gemini tiếng Việt gọi mục này là Cấp độ tư duy như ở bài cách dùng Gemini 4 Argon.
Còn Artificial Analysis là một tổ chức đo độc lập chuyên lấy cùng bộ đề để chấm hàng loạt model. Ở mức high như nhau, hai bên chỉ lệch 2 điểm.
Khi kéo Opus lên max thì cách biệt vọt thành 9 điểm. Tuấn thấy người mới dễ bị nhầm vì nhiều nơi đem Opus max đọ với Argon high.
2. Code và agent: hai model sát nút
Muốn biết bên nào code tốt hơn, bạn đừng tin ảnh chụp khen chê trên mạng. Hãy nhìn vào bài đo độc lập, tức cùng đề, cùng cách chấm do bên ngoài hãng chạy.
2.1 Sửa bug, làm việc code trên dự án lạ
Khi xử lý lỗi thật ở những dự án xa lạ, hai model gần như ngang nhau.
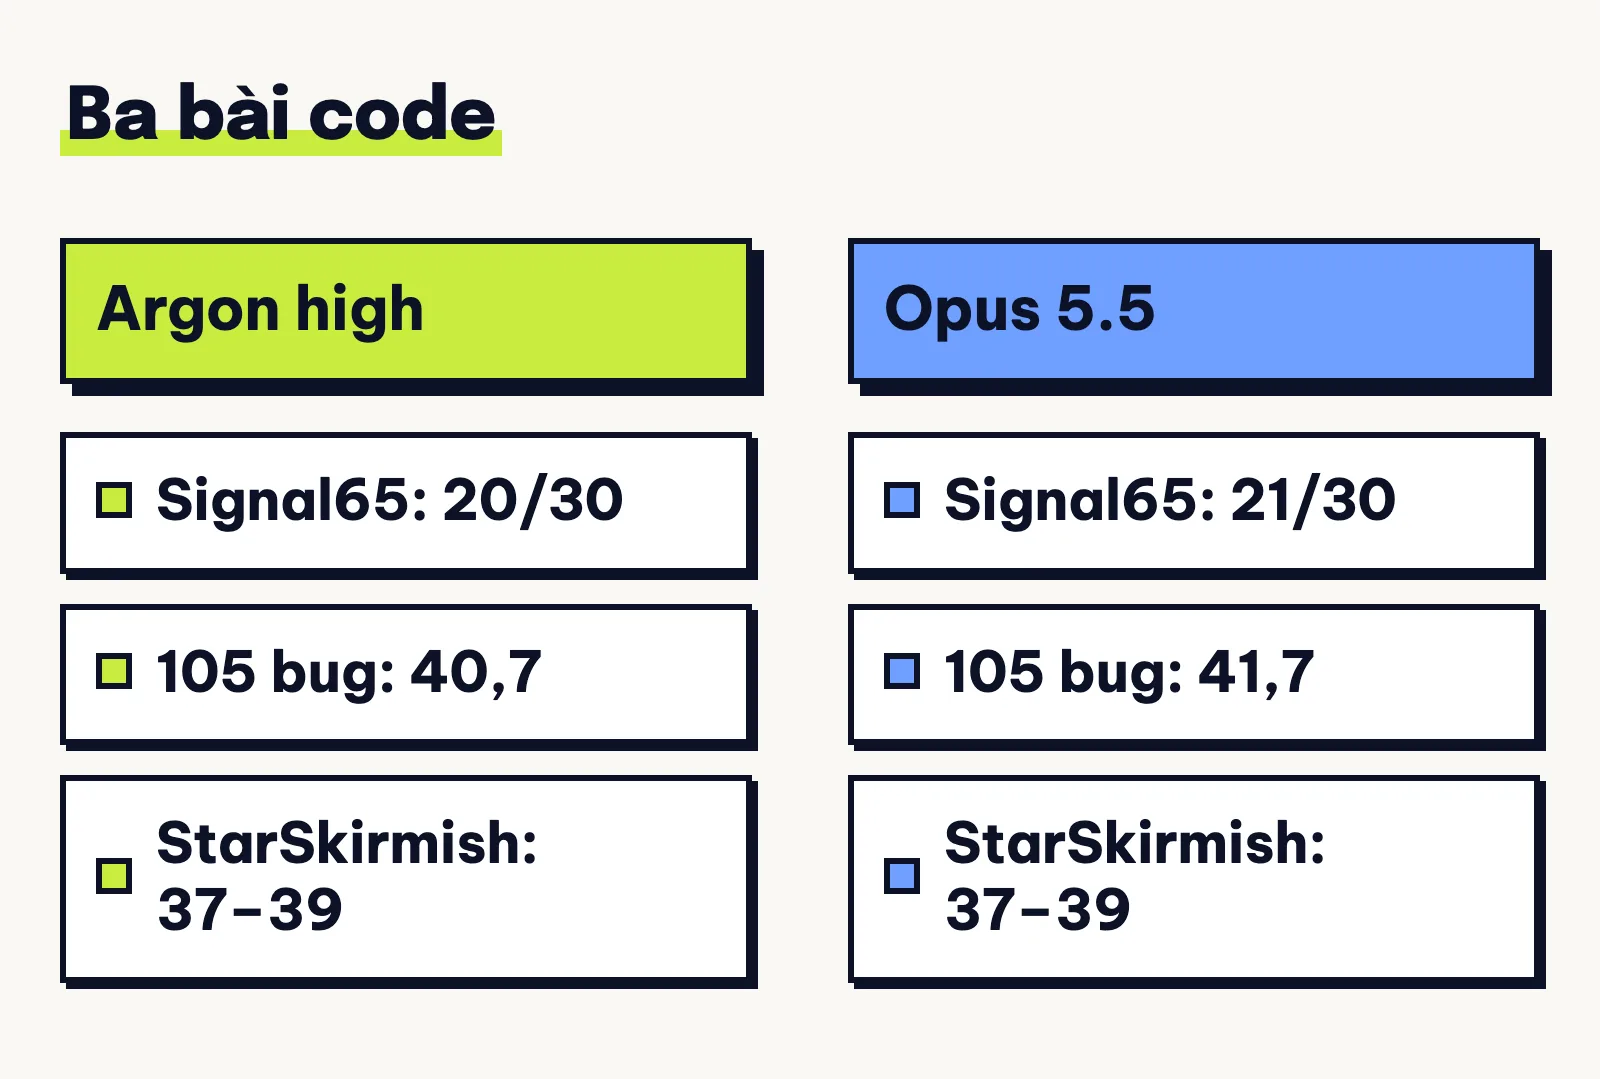
Trên 30 việc code của bài đo PINNACLE từ Signal65, Opus 5.5 xong 21 bài. Argon chạy mức high xong 20 bài, còn bài đo không ghi mức của Opus.
Ở bài thử vá 105 bug thật của Paweł Huryn, Opus mức max đạt 41,7 điểm. Argon chạy 3 lượt ở mức high đạt 40,7 điểm, còn ở medium đạt 39,3 điểm.
Hạ Opus xuống xhigh thì điểm rớt xuống 36, thua cả Argon medium. Vậy mức suy luận cao hơn chưa chắc vá được nhiều lỗi hơn.
StarSkirmish cho mỗi model 1 giờ để viết bot chơi StarCraft. Argon high và Opus max cùng đạt 37 tới 39 điểm. Nhưng lượt hay nhất và dở nhất của Argon chênh 18 điểm, còn Opus chỉ lệch 8 điểm.
Nếu chạy trong công cụ riêng của mỗi hãng trên Coding Agent Index hay FrontierCS 2, hai bên vẫn đứng sát nhau.
Tóm lại khoản sửa bug thì hai model ngang nhau. Tuấn chỉ ngại độ trồi sụt của Argon nên gặp ca khó dễ phải chạy lại lần hai.
2.2 Làm việc trong terminal
Sang chuyện để agent tự chạy lệnh terminal, số liệu trên mạng dễ khiến bạn hiểu lầm.
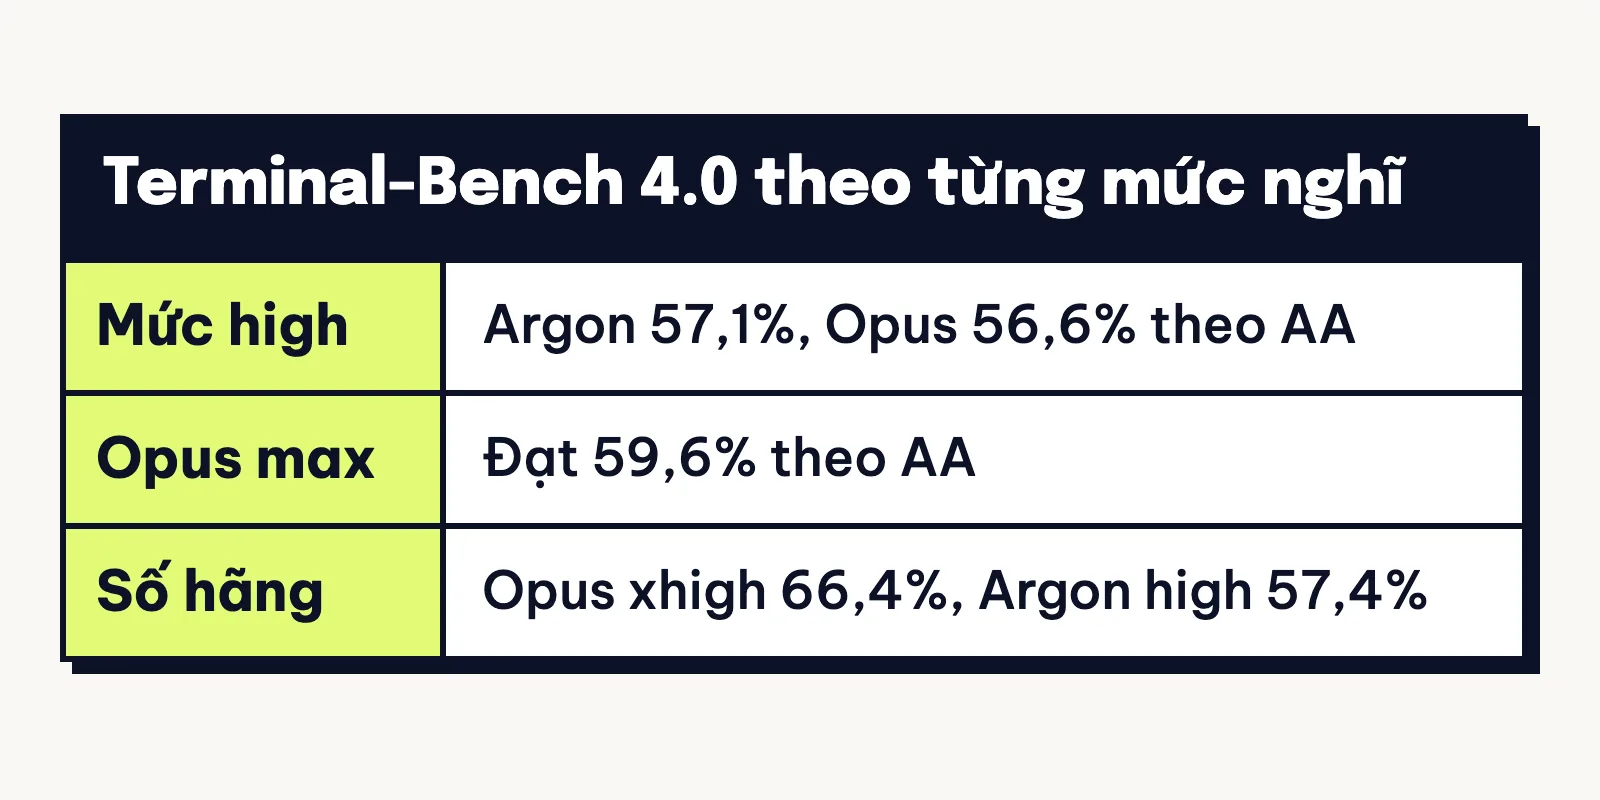
Theo bảng so mức high của Artificial Analysis, bài Terminal-Bench 4.0 chấm Argon 57,1% và Opus 56,6%. Khi kéo Opus lên max thì điểm của nó tăng thành 59,6%.
Bên Vals AI cũng chấm bài này với Opus đạt 65,15 điểm và Argon 57,58 điểm. Trang đo của Vals AI không ghi mức suy luận hai model đã chạy.
Độ chênh lớn nhất nằm ở số hãng tự công bố, tức kết quả do Google và Anthropic tự chạy. Trên trang giới thiệu Claude Opus 5.5 của Anthropic, hãng đo Opus ở mức xhigh đạt 66,4%.
Google bèn lấy số 66,4% đó đặt cạnh mức 57,4% mà họ tự đo Argon ở mức cao nhất. Chính Anthropic cũng nói chênh lệch điểm bài đo giờ khó phản ánh khác biệt thật.
Tuấn chốt ngắn gọn cho bạn dễ nhớ: chạy cùng mức high thì hai bên ngang nhau. Bạn chỉ thấy Opus 5.5 nhỉnh hơn khi kéo lên xhigh hay max.
2.3 Đọc và soát code có sẵn
Nếu bạn hay nhờ AI đọc code cũ rồi tóm tắt lại, phần này mới có ít số liệu.
Anh Theo kênh t3.gg nhận model sớm, cho Argon đọc code riêng. Ngày 13/10 lúc Argon mới ra, anh đếm hơn 50% nhận định sai. Ngày 11/11, bản tóm video của người khác ghi Argon sai 36%, các model Opus 0 tới 1%.
Số này mới từ một người, phần Opus chỉ lấy qua bản tóm của người khác. Dù vậy, nếu cần rà code cũ kỹ thì bạn vẫn nên ưu tiên Opus 5.5.
3. Nhờ dựng trọn app, web, game: Opus 5.5 ra bản đẹp hơn
Nhiều bạn thích dựng một lượt, tức gõ một prompt để model tự làm trọn app hay web mà chưa sửa tay.
Phần này chủ yếu dựa vào test tay, nghĩa là một người tự chạy cùng prompt rồi tự chấm hoặc nhờ AI chấm.
3.1 Bản dựng một lượt có giao diện
Cứ đụng tới sản phẩm có giao diện để nhìn và bấm, kết quả lại nghiêng rõ về một bên.
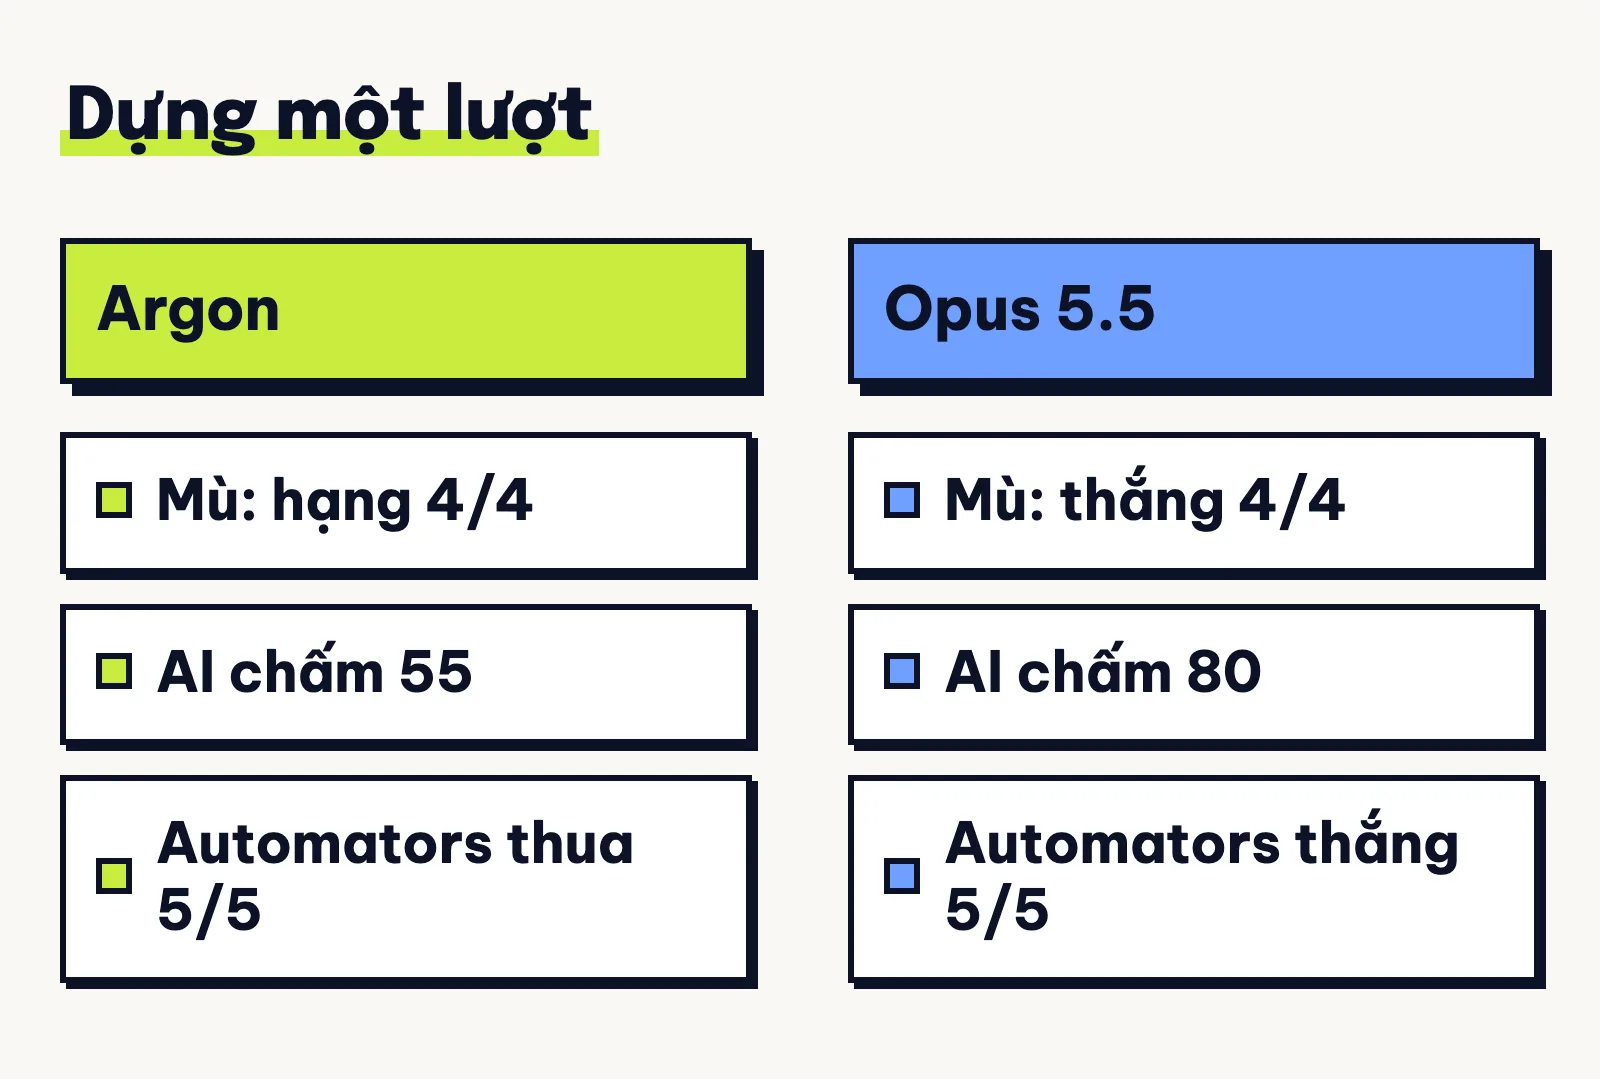
Ở bài thử chấm mù của AI for Mortals, tác giả chạy cả hai ở mức high một lần. Qua 4 món là mô hình chai 3D, video, game và web, Opus thắng trọn.
The AI Automators thử 6 dự án cùng mức high để AI chấm. Opus thắng trọn 5 dự án ghi điểm, dù tác giả nhận máy chấm chưa soi hết chi tiết. Dự án thứ sáu là căn bếp dựng trong Blender, không chấm điểm số. Tác giả cũng thích bản Opus hơn.
DataCamp chọn mức medium dựng web mô phỏng cánh tay robot né vật cản. Vì ở high, Argon chạy cạn 65.536 token suy nghĩ mà không xuất file. Chung cuộc Opus 4,7 điểm, Argon 3,7 điểm.
Với video drone 58 giây của Rhiz3K do 3 model chấm mù, Opus 80 điểm còn Argon 55 điểm. Riêng Vibe Code Bench của Vals AI, bản đo cũ Opus thắng. Sang bản v1.1, hai bên hoà quanh 91 điểm.
Bạn nhớ giúp Tuấn là mấy test tay này chỉ chạy một lần và hay đổi công cụ chạy, tức phần mềm bọc quanh model.
Argon chạy trong Antigravity mượt hơn hẳn so với khi chạy trong công cụ khác. Dù vậy, cần dựng giao diện một lượt cho đẹp thì Tuấn vẫn chọn Opus 5.5.
3.2 Giữ đúng yêu cầu khi chạy lâu
Khi việc kéo dài qua nhiều bước, model rất dễ quên mất điều kiện bạn dặn từ đầu.
- Bài đo Time Horizon của Vals AI: Opus đạt 91,33 điểm còn Argon đạt 52,50 điểm, không ghi mức suy luận.
- Bài tay máy của DataCamp ở medium: Opus chạy tới cuối không đụng vật cản, còn Argon về sau bị chạm.
Tuấn khuyên thật là gặp việc dài hơi nhiều điều kiện, bạn cứ giao cho Opus 5.5 cho chắc ăn.
4. Việc văn phòng, giấy tờ chuyên ngành, báo cáo
Rời màn hình code để sang giấy tờ văn phòng, hai model lại chia nhau mỗi bên giữ một góc riêng.
4.1 Tự động làm việc qua nhiều tool: Argon nhỉnh
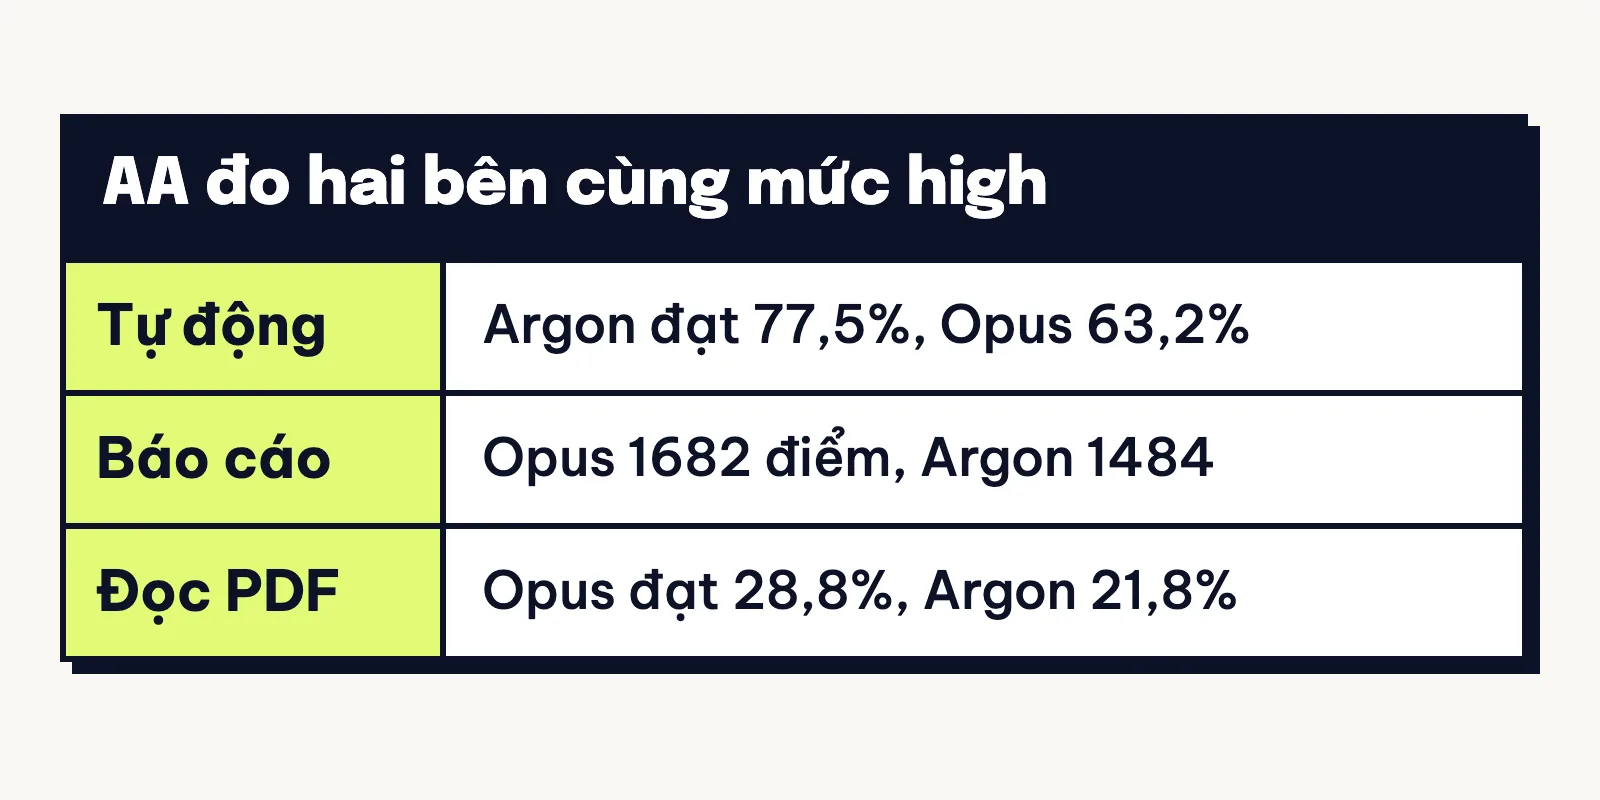
Trên bài đo AutomationBench-AA của Artificial Analysis, model phải tự gọi nối tiếp nhiều công cụ văn phòng. Cùng mức high, Argon ghi 77,5% còn Opus 5.5 đạt 63,2%.
Kể cả khi đẩy Opus lên hẳn mức max, điểm của nó cũng chỉ nhích lên 69,5%. Nếu bạn hay chạy quy trình nối nhiều app văn phòng, Tuấn thấy Argon đáng dùng hơn hẳn.
4.2 Luật, mã bệnh án, kế toán: Argon nhỉnh
Sang nhóm giấy tờ chuyên ngành cần bám sát quy định, lợi thế tiếp tục thuộc về model nhà Google.
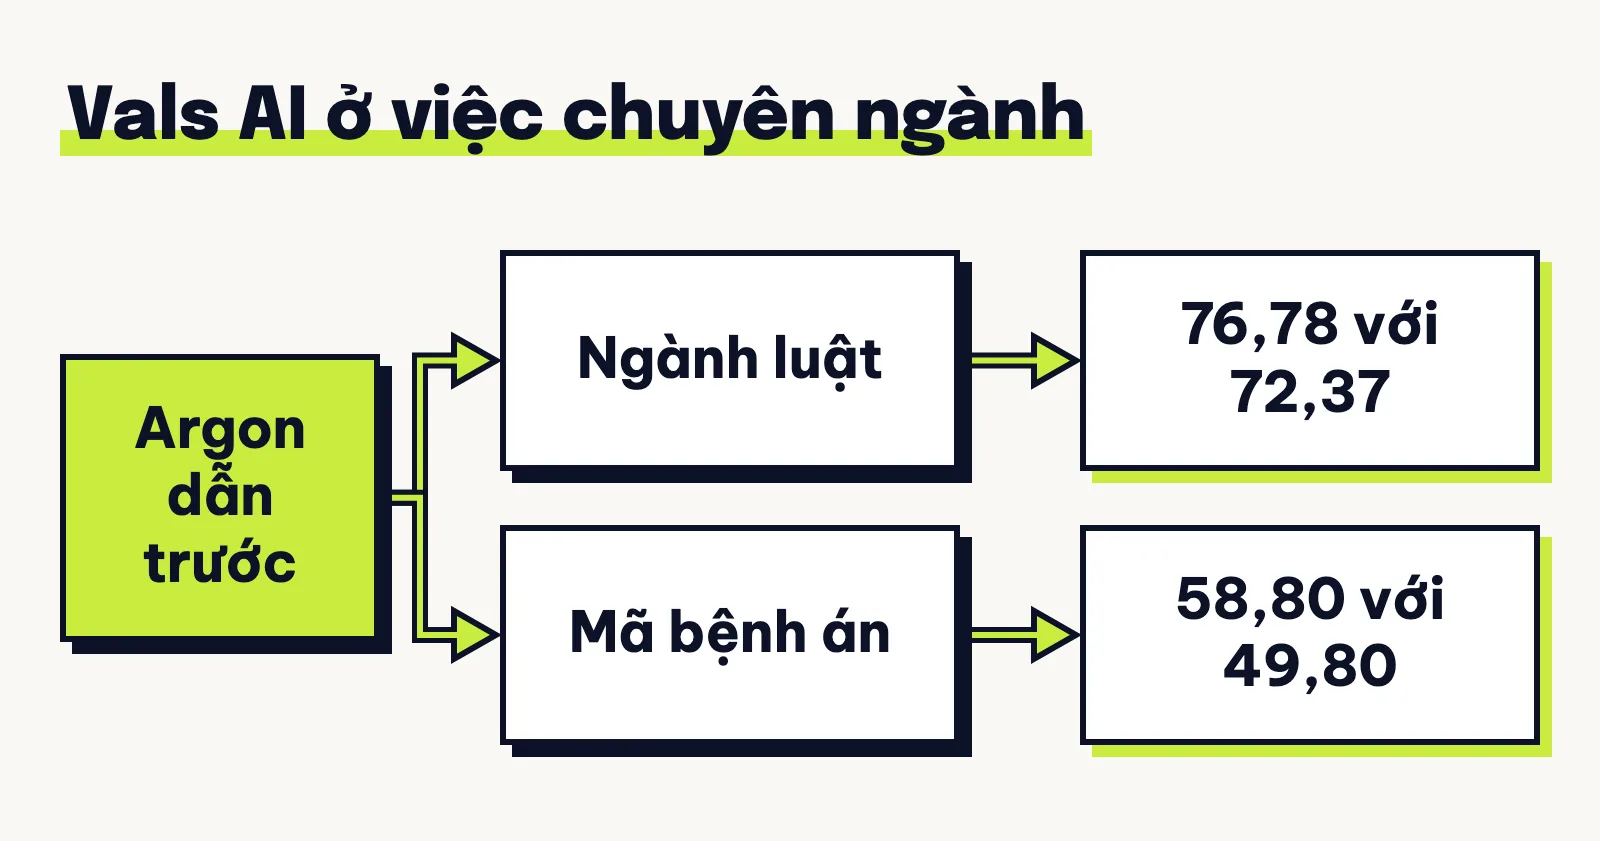
Trên trang đối chiếu của Vals AI, Argon dẫn trước ở bài luật với 76,78 so với 72,37. Ở bài gán mã bệnh án, Argon đạt 58,80 so với 49,80 của Opus.
Điểm cần nhớ là trang Vals AI không ghi hai model chạy ở mức suy luận nào. Ngoài ra, hãng phần mềm Ramp Labs thử việc kế toán thật và chấm Argon 61,1% so với 50,5% của Opus, dù họ chưa công bố hết cách chấm.
Dù còn thiếu vài thông tin từ bên đo, hướng nghiêng về Argon ở giấy tờ chuyên ngành đã khá rõ.
4.3 Làm báo cáo, đọc PDF dài: Opus 5.5 nhỉnh
Ngược lại, nếu bạn cần viết báo cáo chỉn chu hoặc đọc PDF nhiều trang, Opus 5.5 lại làm mượt hơn.
Cùng mức high trên Artificial Analysis, bài đo chất lượng tài liệu công việc chấm Opus 1682 điểm, Argon 1484. Kéo Opus lên max thì điểm vọt lên 1801.
Ở bài đọc hiểu PDF, Opus đạt 28,8% còn Argon được 21,8%. Với tài liệu siêu dài tới 1 triệu token, Google tự đo Argon đạt 84,2% so với 66,8% nhưng chưa có bên độc lập kiểm lại.
Với cỡ báo cáo và PDF phổ thông, Tuấn vẫn khuyên chọn Opus 5.5 cho câu chữ gãy gọn.
5. Hỏi kiến thức: ít đoán bừa chưa chắc đã trả lời đúng nhiều
Nhiều bạn nghe Argon ít đoán bừa, tức tỉ lệ nói sai ở những câu không biết rất thấp. Từ đó bạn dễ tưởng nó trả lời đúng nhiều hơn, nhưng bảng điểm lại khác hẳn.
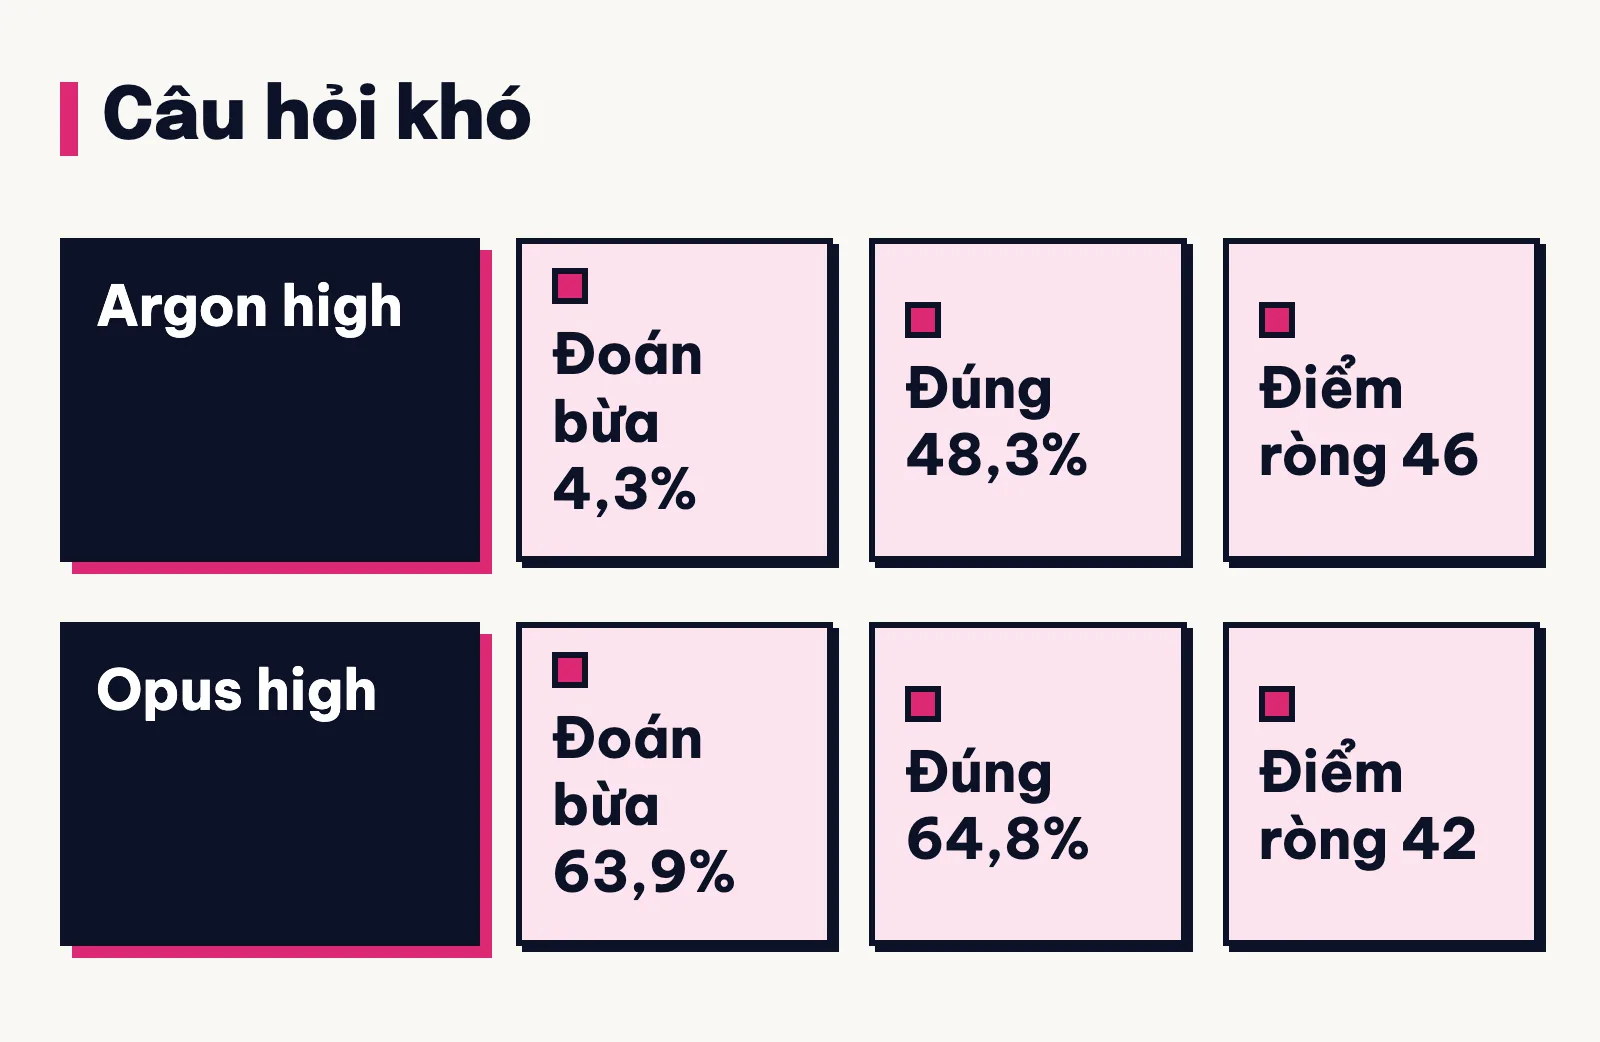
Trong bộ đo AA-Omniscience của Artificial Analysis gồm 3.000 câu hỏi, câu nào không biết thì Argon rất chịu nhận không biết. Nhờ vậy Argon ở mức high chỉ đoán bừa 4,3%.
Bên kia, Opus ở mức high đoán bừa tới 63,9% nhưng tỉ lệ trả lời đúng đạt 64,8%, vượt xa mức 48,3% của Argon. Kéo Opus lên max thì đoán bừa giảm về 50,3% còn tỉ lệ đúng lên 65,5%.
Vì bài đo phạt nặng câu sai mà không phạt câu nhận không biết, điểm ròng của Argon đạt 46. Opus high được 42 điểm ròng, lên max đạt 48 điểm.
Bạn cứ tách làm hai nhu cầu rõ ràng nhé. Cần câu trả lời an toàn để khỏi dính thông tin đoán bừa thì hỏi Argon, còn muốn giải được nhiều câu khó thì dùng Opus 5.5.
6. Tốc độ và game chiến lược
6.1 Model nào trả lời nhanh hơn
Đừng vội kết luận model nào nhanh hơn vì tốc độ thực tế đảo chiều theo từng việc.
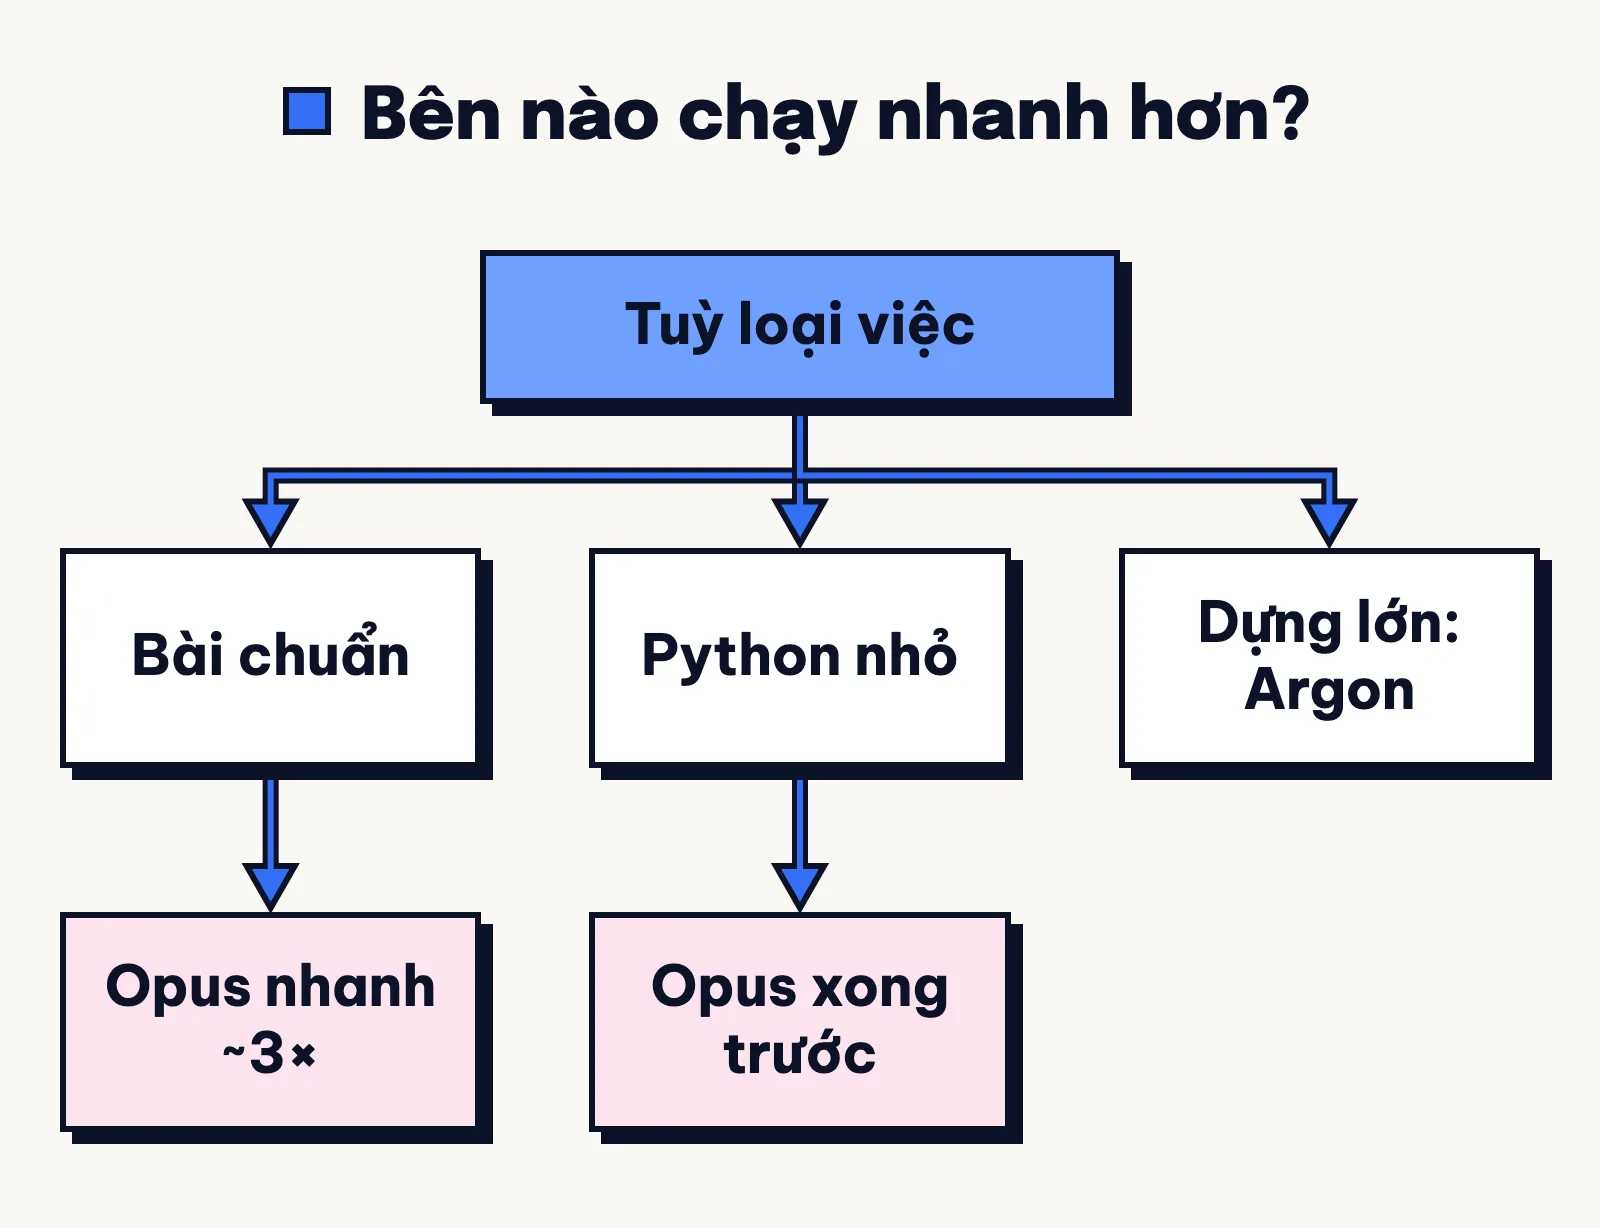
- Bài đo chuẩn: Cùng mức high trên Artificial Analysis, Opus mất 9,5 phút mỗi bài còn Argon mất 30,0 phút.
- Việc Python nhỏ: Ở bài QuickSilver Pro mức mặc định hay bên OmniaKey, Opus đều xong nhanh hơn hẳn.
- Bản dựng lớn: Dựng 4 sản phẩm mức high ở AI for Mortals, Argon mất 247 phút so với 715 phút của Opus.
Tuấn thấy khá lạ ở chỗ này: giải đề chuẩn thì Argon ngâm lâu gấp ba, nhưng dựng app lớn thì Opus 5.5 lại khiến bạn ngồi chờ.
6.2 Tự chơi game chiến lược: Argon hơn rõ
Nếu bạn tò mò xem AI tự điều khiển chuột phím chơi game chiến lược thì sao, khoảng cách ở đây khá xa.
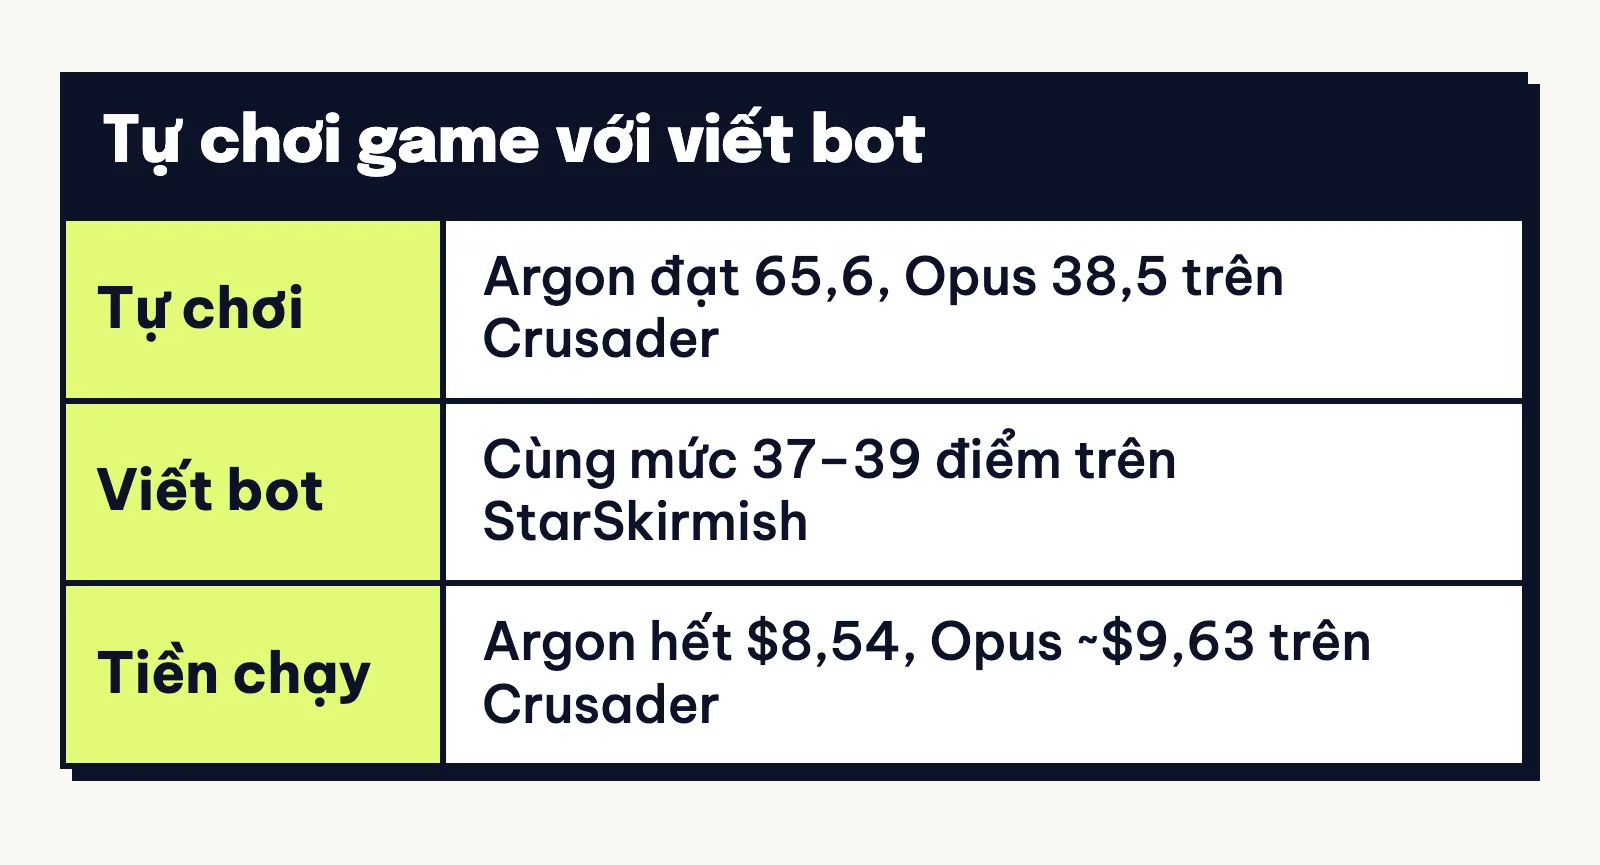
Theo bảng điểm Crusader Bench chơi 6 ván ở mức medium, Argon đạt 65,6 điểm bỏ xa mức 38,5 điểm của Opus. Tiền chạy trọn 6 ván của Argon hết $8,54, nhẹ hơn mức khoảng $9,63 của Opus.
Nhưng đừng gộp chuyện này thành Argon chơi mọi thứ về game đều hay hơn nhé. Bài viết bot StarCraft bằng code hai bên vẫn hoà, nên chỉ khoản tự cầm quân chơi trực tiếp mới nghiêng về Argon.
7. Tiền mỗi việc trước và sau 01/12
Tới 30/11 giá token Argon rẻ một nửa nên nhiều bạn tưởng tiết kiệm. Tính tiền mỗi việc, bài đo chạy cùng mức cho Opus rẻ hơn hoặc ngang. Test tay dựng một lượt thì Argon rẻ hơn.
Nếu hay tự gọi API, bạn xem kỹ ở bài Gemini 4 Argon API. Dưới đây mình chỉ tính tiền mỗi việc.
7.1 Vì sao giá token rẻ chưa chắc việc rẻ
Mấu chốt nằm ở token suy nghĩ, tức phần chữ model tự nghĩ nháp trước khi viết câu trả lời. Cả Google và Anthropic đều cộng phần này vào token ra để tính tiền.
Bởi vậy tiền mỗi việc bạn trả là giá token nhân với tổng số token model thực sự tiêu. Trên Artificial Analysis cùng mức high, Argon dùng tới 116 nghìn token ra mỗi bài, gần gấp đôi 60,1 nghìn của Opus.
Tới hết 30/11, giá token Argon bằng nửa Opus 5.5 nên gần bù được lượng token ra gấp đôi. Nhưng tiền mỗi bài cùng mức high trên Artificial Analysis, Argon vẫn hết $4,97 so với $3,46 của Opus.
Từ 01/12 giá hai bên bằng nhau $4 và $20 thì tiền mỗi việc của Argon sẽ đội lên rõ.
7.2 Chạy bài đo chuẩn: cùng mức high thì Opus 5.5 rẻ hơn
Khi chạy cùng điều kiện trên bài đo chuẩn, tiền thật mỗi bài sẽ khiến nhiều người bất ngờ.
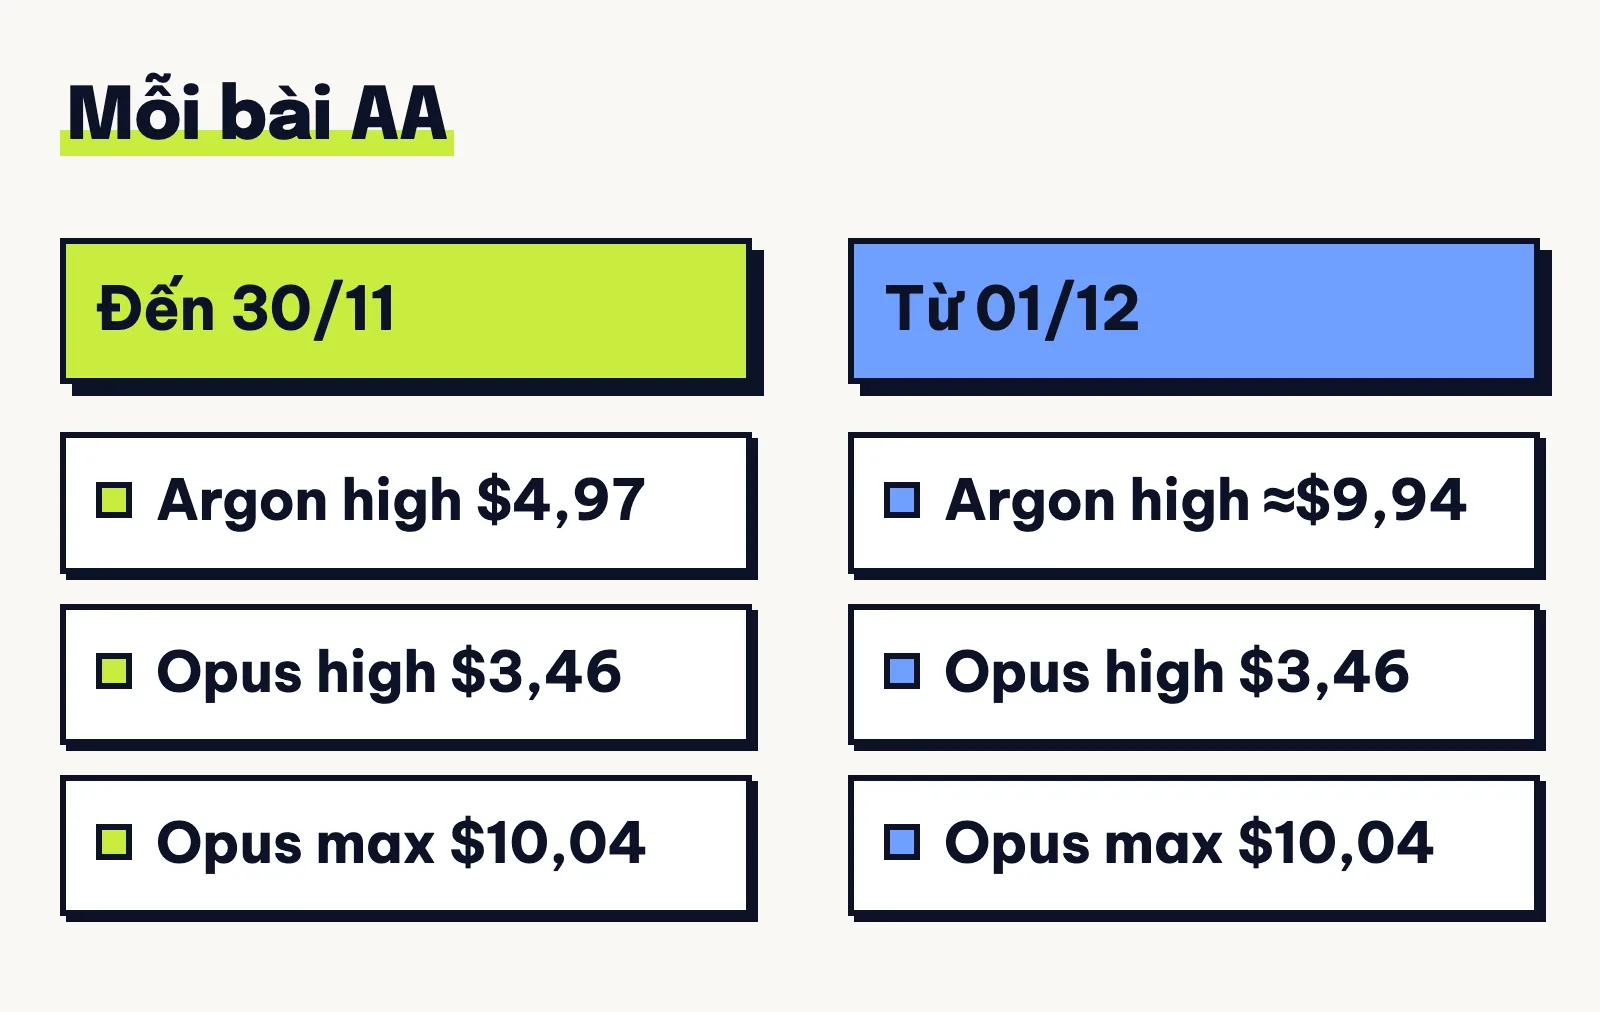
Trên Artificial Analysis cùng mức high, một bài của Argon tốn $4,97 theo giá tới 30/11. Con số đó rẻ hơn Opus max tốn $10,04 nhưng đắt hơn Opus high chỉ tốn $3,46.
Nếu giữ nguyên lượng token sang ngày 01/12, phép tính nhân đôi đưa Argon lên khoảng $9,94, gần bằng Opus max. Hiện vẫn chưa có số đo tiền hay điểm của Opus 5.5 ở mức mặc định medium.
| Bài đo | Argon | Opus 5.5 | Mức, giá token |
|---|---|---|---|
| Artificial Analysis cùng high | $4,97 tới 30/11; tính $9,94 từ 01/12 | $3,46 | Cả hai high; tính nhân đôi |
| Artificial Analysis Opus max | $4,97 tới 30/11; tính $9,94 từ 01/12 | $10,04 | Argon high; Opus max |
| Vals Terminal và Legal | Terminal $17,64; Legal $6,82 | Terminal $12,04; Legal $19,94 | Không ghi mức, giá token |
| Signal65, tiền mỗi việc đạt | Tính $5,75 tới 30/11; $11,49 từ 01/12 | $7,80 | Argon high; Opus không nêu |
Nhìn bảng trên, bài Artificial Analysis cùng mức high thì Opus 5.5 rẻ hơn cả hai mốc. Trên Signal65 không nêu mức Opus, Argon rẻ hơn tới 30/11 rồi đắt hơn từ 01/12. Còn Vals không ghi mức lẫn giá tính, Opus rẻ hơn ở Terminal và Argon rẻ hơn ở bài luật.
7.3 Dựng một lượt: Argon rẻ hơn nhiều, nhưng bản kém hơn
Ngược lại hoàn toàn với bài đo chuẩn, ở các lần tự chạy dựng sản phẩm thì Argon lại rẻ hơn nhiều.
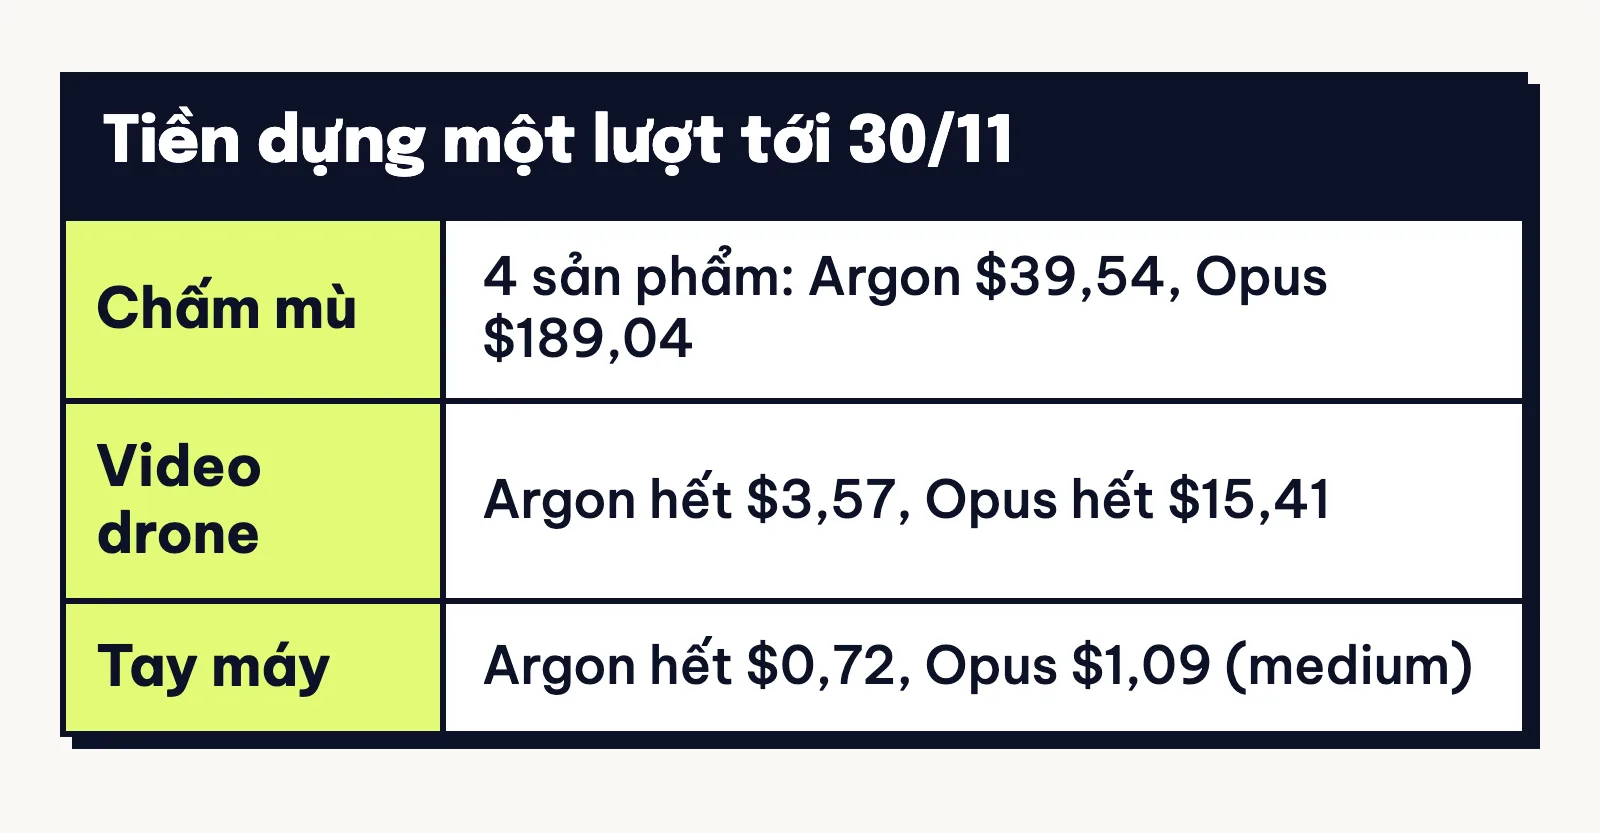
Ở bài dựng 4 sản phẩm của AI for Mortals, Argon hết $39,54 giá tới 30/11, bét cả 4 vòng. Còn Opus tốn $189,04 để thắng trọn.
Bài video drone của Rhiz3K cũng vậy, Argon hết $3,57 được 55 điểm còn Opus hết $15,41 được 80 điểm.
Bốn test tay khác trên X là bốn lần thử lẻ, mỗi model chạy công cụ riêng. Argon rẻ hơn ở cả bốn bài. Opus đẹp hơn ở bài game 3D và phim 3D. Một bài khác cho kết quả gần như nhau. Bài gấu dưa hấu thì Argon hết $0,77 sau 6 lần sửa, còn Opus hết $5,05 một lần.
Sang 01/12, nếu cùng số token thì phép tính nhân đôi có thể làm kết quả đảo chiều. Như bài tay máy DataCamp ở medium, Argon tốn $0,72 tới 30/11 nhưng nhân đôi thành $1,44 là đắt hơn mức $1,09 của Opus.
Riêng mấy việc Python nhỏ ở QuickSilver Pro theo giá hãng, Argon nhân đôi lên $0,281 vẫn rẻ hơn $0,379 của Opus. Tuấn thấy cứ dùng Argon dựng nháp cho nhẹ ví, cần bản đẹp hẳn hãy gọi Opus 5.5.
8. Dùng qua gói tháng: ở đâu có cả hai, ai hết lượt trước
Đa số bạn đọc chắc trả gói tháng chứ ít khi nạp tiền gọi API từng câu. Vậy gói nào có cả hai model, và bên nào nhanh hết lượt hơn?
8.1 Gói nào có Argon, gói nào có Opus 5.5
Nếu dùng app riêng từng hãng, Argon có trên app Gemini và AI Studio từ gói Google AI Pro trở lên.
Còn muốn dùng Opus bên Anthropic, bạn cần xem trang giá các gói Claude. Tài khoản miễn phí không có Opus, phải trả từ gói Claude Pro $20 một tháng hoặc gói Claude Max $100 và Claude Ultra $200.
Chỗ tiện nhất cho người viết code là Antigravity, công cụ lập trình bằng agent của Google có sẵn cả hai model.
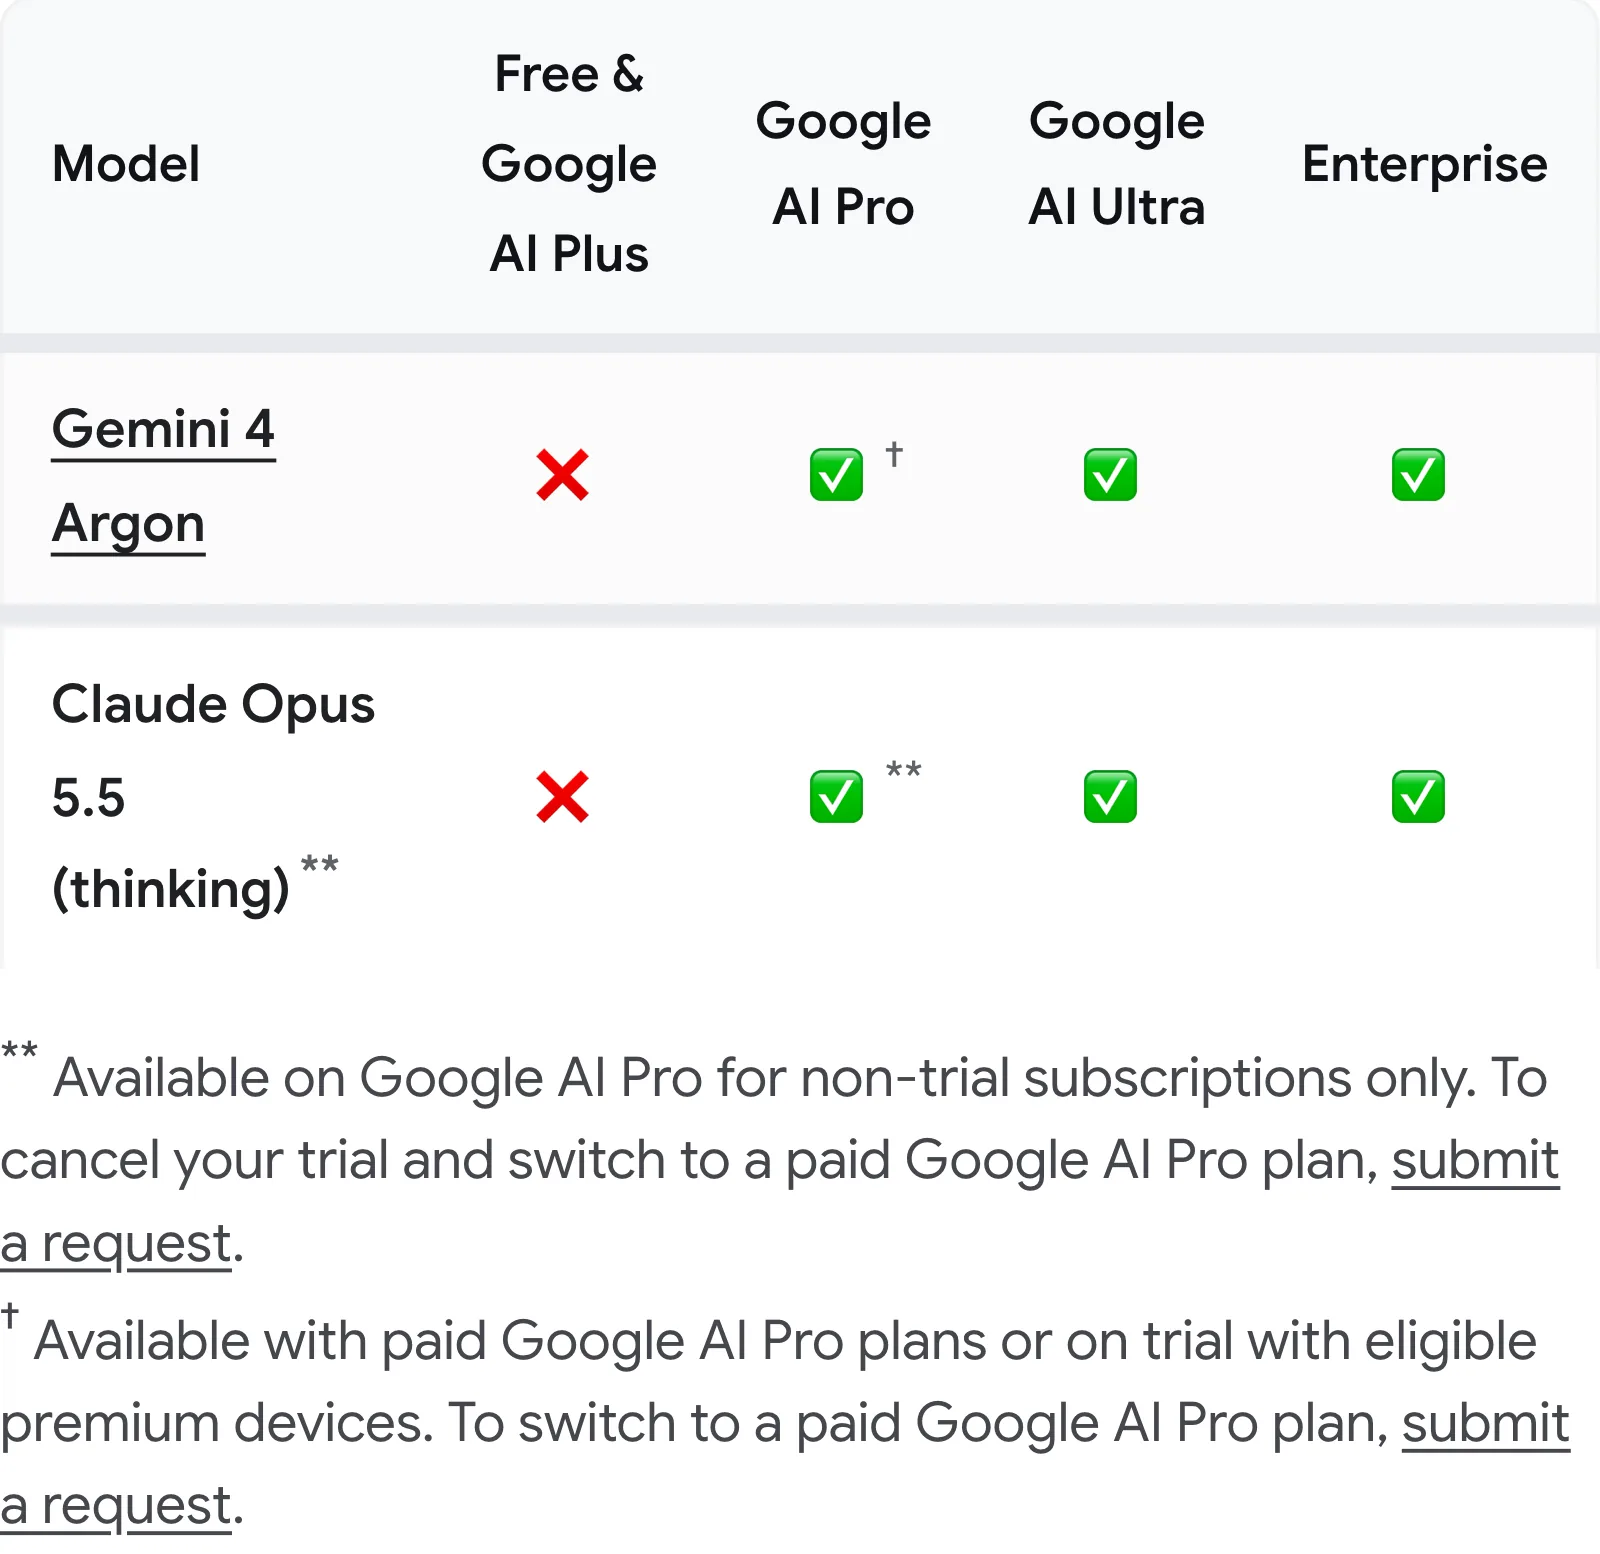
Theo danh sách model theo gói của Antigravity, gói Google AI Pro trả tiền, trừ bản dùng thử, mở được Argon lẫn Opus 5.5. Tài khoản miễn phí và gói Google AI Plus đều không có hai model này.
Chi tiết cách bật và điều kiện của gói, bạn xem thêm bài Gemini 4 Argon trong Antigravity Tuấn đã viết riêng.
8.2 Argon chạm hạn mức nhanh hơn
Dùng chung một gói tháng nhưng nhiều người lại gặp cảnh đụng hạn mức, tức mức dùng tối đa gói cho phép trong khung giờ hoặc một ngày.
Hai người thử dựng sản phẩm mức high đều dùng gói Google AI Ultra $99,99/tháng. Gói này có hạn mức gấp 5 lần gói Google AI Pro. Thế mà một người vẫn đụng hạn mức ngày của Argon sau khi dựng chừng một sản phẩm. Người kia chạy 6 dự án cũng bị khoá giữa chừng vì chạm hạn mức 5 giờ.
Hiện chưa ai đo cùng việc, cùng gói để chốt gói nào cho dùng nhiều lượt hơn. Một người điều hành diễn đàn Google cũng nhắc hạn mức Antigravity không tính theo giá token công khai.
Để giữ hạn mức đỡ hụt hơi giữa chừng, bạn xem thêm bài hạn mức Gemini 4 Argon nha.
9. Có Gemini 4 Hydrogen rồi, việc thường còn cần Argon hay Opus 5.5 không
Google vừa tung Gemini 4 Hydrogen hôm 12/11/2026 nên nhiều bạn phân vân việc nhẹ có cần tới hai model lớn kia không.
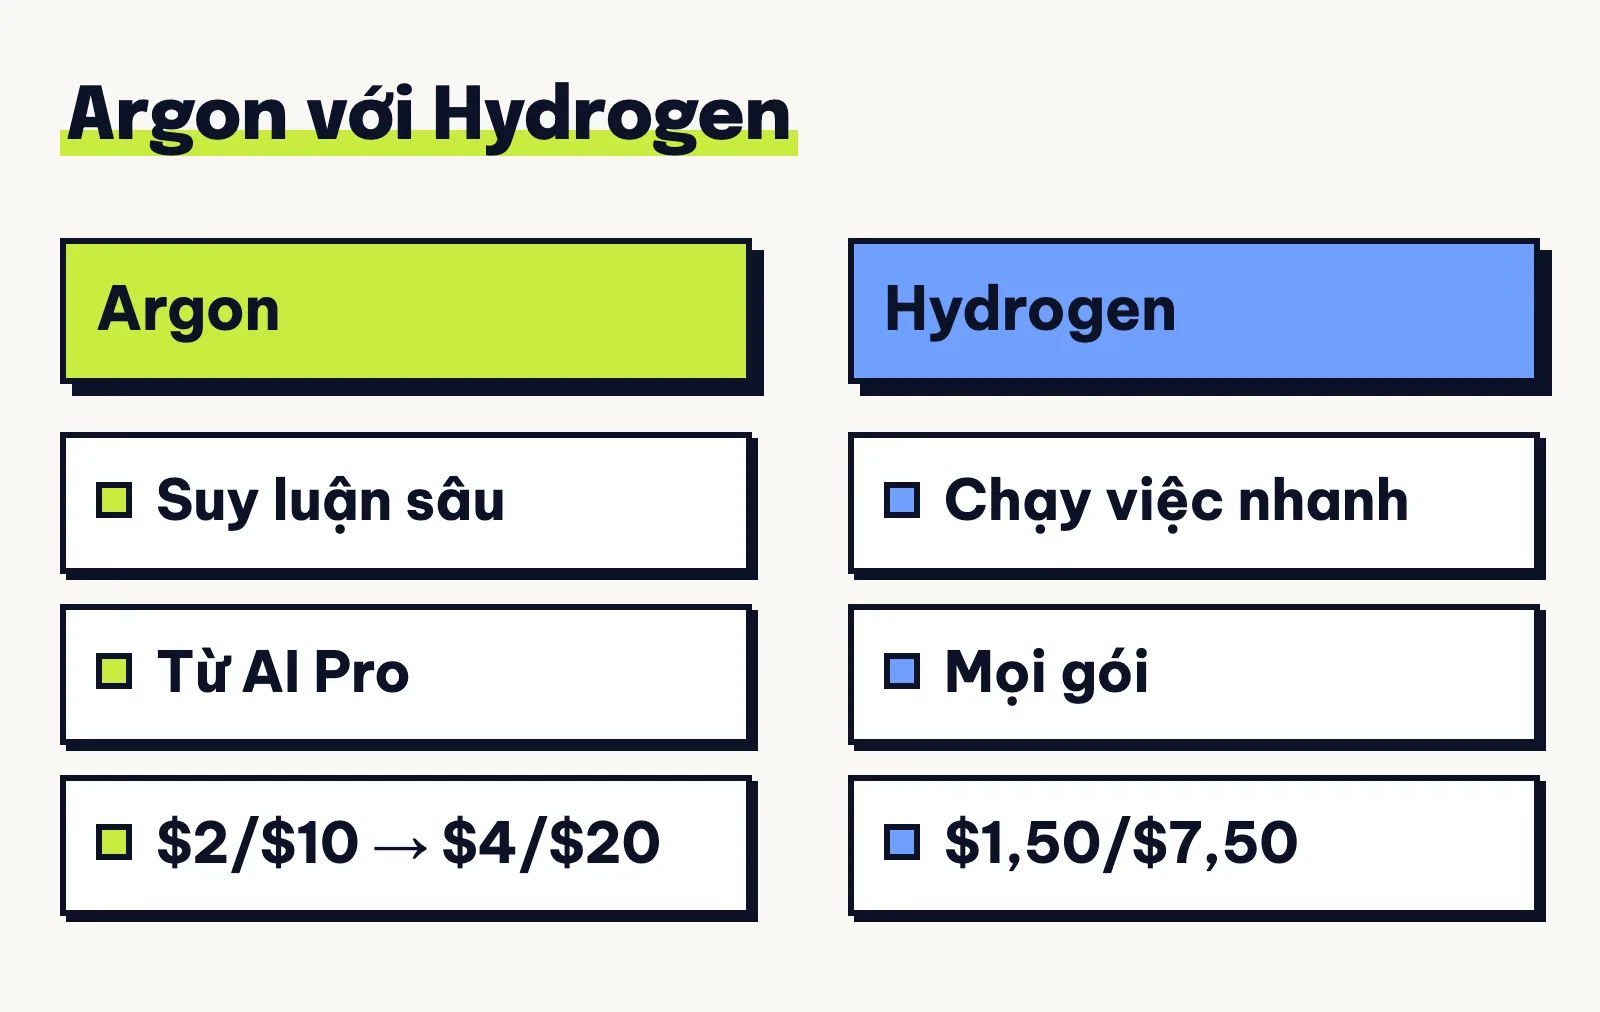
Nguyên tắc dễ nhớ là việc thường cứ giao model nhanh gọn trước, việc khó kéo dài mới gọi model suy luận nặng.
Google làm Hydrogen cho việc code, xử lý nhanh hằng ngày. Bạn dùng miễn phí trên AI Studio. Trong Antigravity, gói Google AI Pro có sẵn Hydrogen. Giá token $1,50 vào, $7,50 ra.
Google tự công bố Hydrogen đạt 51 điểm Artificial Analysis so với 50 của Argon ở mức high. Còn chính Artificial Analysis ghi nhận Hydrogen ngang điểm Argon nhưng chỉ tốn khoảng 19% tiền mỗi việc.
Hiện chưa có bài nào so Hydrogen với Opus 5.5, nhưng việc lặt vặt thì Tuấn khuyên bạn cứ gọi Hydrogen trước cho đỡ hao gói.
10. Đặt GPT-6.1 Sol và GPT-6 Astra vào thì sao
Nếu dùng thêm model OpenAI, xem GPT-6.1 Sol và GPT-6 Astra đứng đâu cạnh hai bên cũng đáng chú ý.
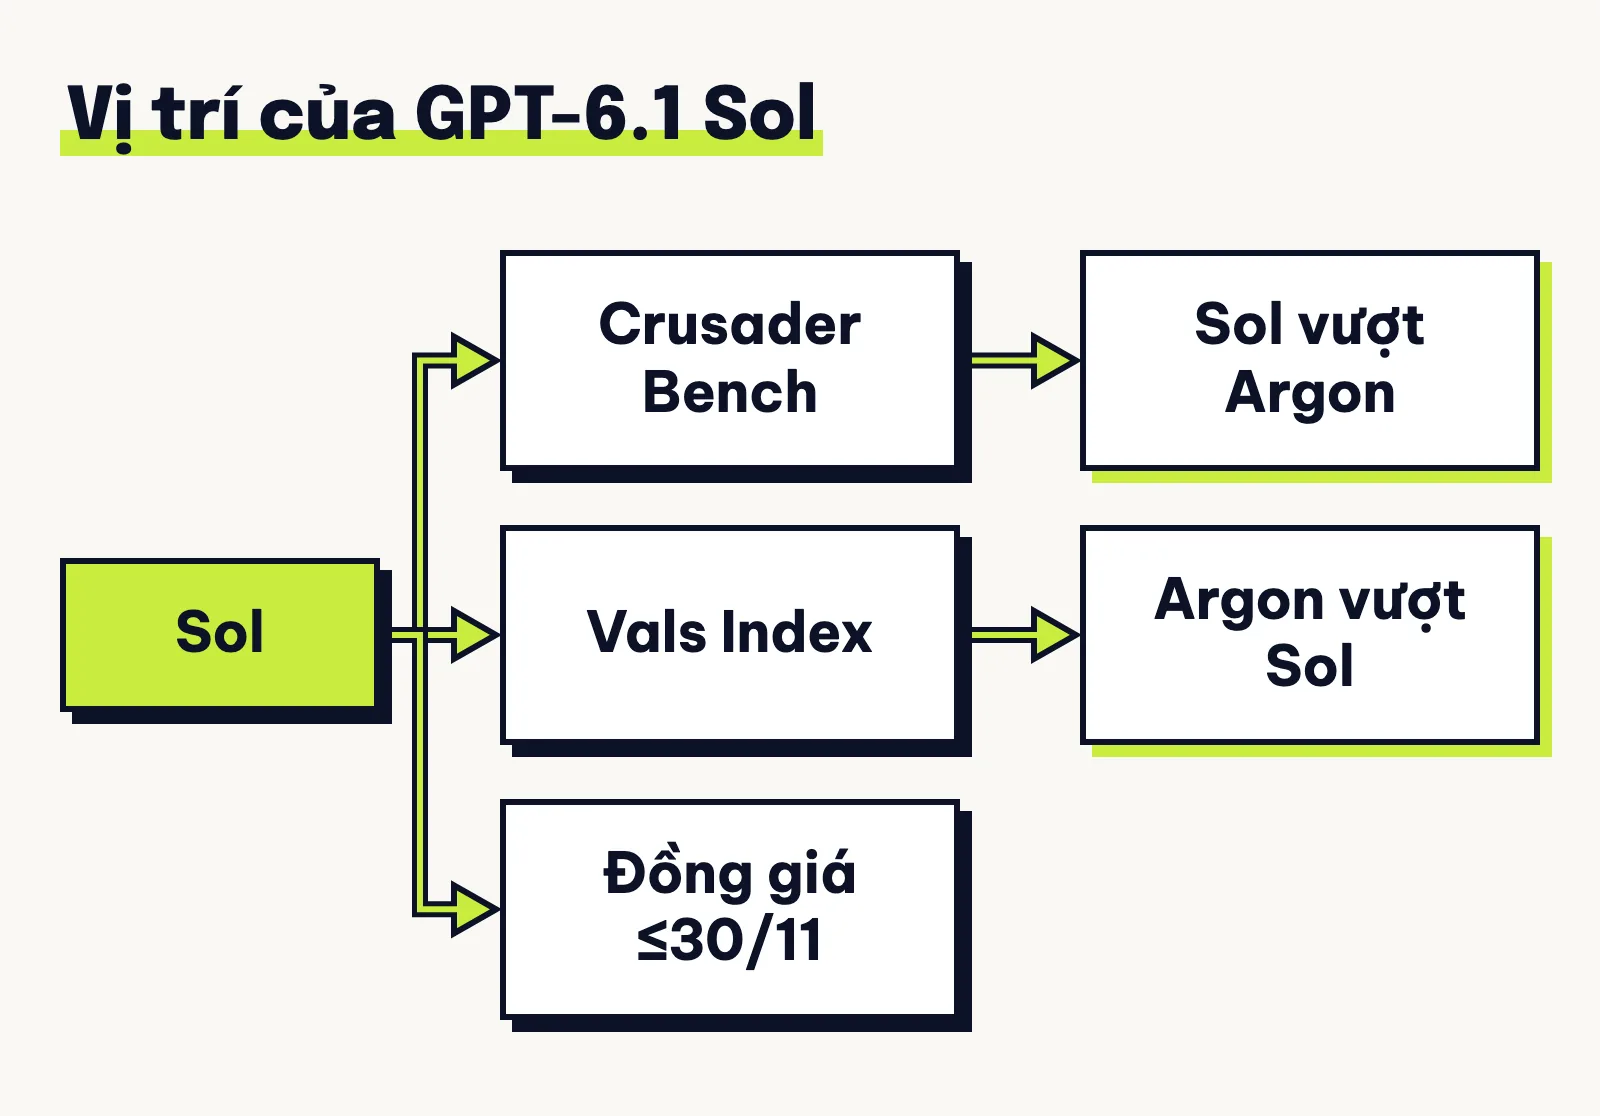
Theo trang thông số GPT-6.1 Sol của OpenAI, model này có giá token $2 vào và $10 ra, bằng giá Argon tới 30/11.
Trên Crusader Bench, Sol đạt 69,7 điểm, hơn Argon và bỏ xa Opus nhưng trang không ghi mức suy luận của Sol. Ở bài viết bot StarCraft, GPT-6 Astra dẫn đầu còn Sol xếp trên nhóm Argon và Opus.
Ngược lại trên Vals Index, Argon đạt 69,39% với $13,37 mỗi lượt, cao hơn mức 63,94% với $3,61 của Sol. Còn ở bài FrontierCS 2 chạy trong Antigravity, Argon lại vượt GPT-6 Astra để bám sát Opus.
Nói gọn là không model nào trong ba nhà thắng mọi bài, bạn cứ chọn đúng điểm mạnh từng món.
11. Chọn Gemini Argon hay Claude Opus 5.5 cho việc của bạn
Sau khi đi qua đủ bảng điểm và tiền thật, giờ mình gom lại theo đúng nhu cầu hằng ngày để bạn chọn cho nhanh.
11.1 Chọn Gemini 4 Argon nếu…
Bạn nên ưu tiên mở Argon trước nếu công việc rơi đúng vào những nhóm dưới đây.
(Ảnh: Google)
- Tự động hoá văn phòng: Cần model tự gọi nối tiếp nhiều công cụ trong quy trình hằng ngày.
- Giấy tờ chuyên ngành: Làm hồ sơ luật, mã bệnh án hay kế toán cần bám sát quy định.
- Cần tránh đoán bừa: Muốn AI chịu nhận không biết khi gặp câu khó thay vì nói đại.
- Dựng nháp trước 30/11 hoặc chơi game chiến lược: Muốn thử ý tưởng nhẹ tiền hoặc để AI tự chơi game.
- Đang trả gói Google AI Pro: Gói có sẵn Argon trên app lẫn Antigravity. Bạn cứ thử trước khỏi mua thêm gói ngoài.
11.2 Chọn Claude Opus 5.5 nếu…
Ngược lại, những việc đòi hỏi độ chỉn chu về giao diện và chữ nghĩa lại hợp với Opus 5.5 hơn.
(Ảnh: Anthropic)
- Dựng sản phẩm có giao diện: Cần dựng một lượt ra web, app hay cảnh 3D đẹp mắt ngay.
- Việc kéo dài nhiều bước: Cần model giữ đúng mọi yêu cầu từ đầu tới phút chót.
- Làm báo cáo và đọc PDF: Viết tài liệu gọn đẹp hoặc đọc hiểu PDF nhiều trang.
- Soát lại code cũ: Muốn AI đọc kỹ code có sẵn dù mới có số từ một người thử.
- Chạy đều ở mức high: Muốn tiền mỗi việc ổn định và đỡ lo chạm hạn mức sớm như Argon.
11.3 Chỗ chưa đủ bằng chứng để chọn
- Viết lách và tiếng Việt: Chưa có bài đo có số liệu nào so sánh hai model bằng tiếng Việt.
- Gói tháng dùng được bao lâu: Chưa có bài đo nào đặt hai gói cạnh nhau trên cùng một việc.
Với việc code vốn ngang nhau hoặc tiếng Việt chưa rõ bên nào hay hơn, bạn dùng gói Google AI Pro cứ mở Antigravity lên. Hãy chạy thử đúng một việc thật của mình trên cả hai model rồi tự chốt nhé.
Tuần này bạn định giao việc code, làm giấy tờ hay dựng app cho model nào, bình luận bên dưới kể Tuấn nghe với nha.
Tin mới về Gemini
Nhắn cho Tuấn ở đây nhé